OpenAI выпустила GPT-6 Sol и Luna и вдвое снизила цены
GPT-6 Sol и GPT-6 Luna достраивают линейку GPT-6 , которую в начале сентября открыла флагманская Astra . OpenAI подаёт релиз как перенос возможностей Astra в работу, где важны скорость и бюджет. Главный аргумент компании — лучший результат за каждый потраченный доллар. Обе модели доступны в API, в ChatGPT и Codex их включают постепенно.
OpenAI ответила Anthropic в тот же день
22 сентября Anthropic выпустила Claude Opus 5.5 и сделала главным аргументом цену. Модель обходится на 40% дешевле прошлой Opus 5 и стоит 4 доллара за миллион входных токенов и 20 за миллион выходных. В тот же день OpenAI показала GPT-6 Sol, которая по обеим ставкам ровно вдвое дешевле, — 2 и 10 долларов.
Совпадение дат выглядит неслучайным, хотя логика у двух релизов разная. Anthropic довела среднюю модель почти до уровня своей верхней Fable 5.1. OpenAI оставила верхнюю ступень за Astra и сбросила цену на всё, что ниже. Разработчику, который платит за API сам, теперь мало таблиц бенчмарков. Сравнивать модели приходится по стоимости решённой задачи.
Три ступени GPT-6
С выходом Sol и Luna линейка GPT-6 собрана целиком. Ставки API за миллион токенов на входе и выходе такие:
- GPT-6 Luna — 0,1 и 0,5 доллара, самая быстрая и дешёвая модель для массовых задач;
- GPT-6 Sol — 2 и 10 долларов, рабочая модель для программирования, агентов и профессиональной работы;
- GPT-6 Astra — 10 и 50 долларов, лучший результат там, где цена вторична.
Предшественницы GPT-5.6 Sol и Luna продавались по акционным ставкам 4 и 20 долларов и 0,2 и 1,2 доллара соответственно. OpenAI объясняет снижение улучшениями в кэшировании и работе серверов и говорит, что передаёт экономию клиентам. Выходные токены Luna подешевели даже больше, чем вдвое, примерно на 58%.
Для сравнения с Claude . GPT-6 Sol стоит столько же, сколько Claude Sonnet 5, а Luna в десять раз дешевле самой младшей Claude Haiku 4.5, у которой ставки 1 и 5 долларов.
С кем GPT-6 Sol сравнивает себя
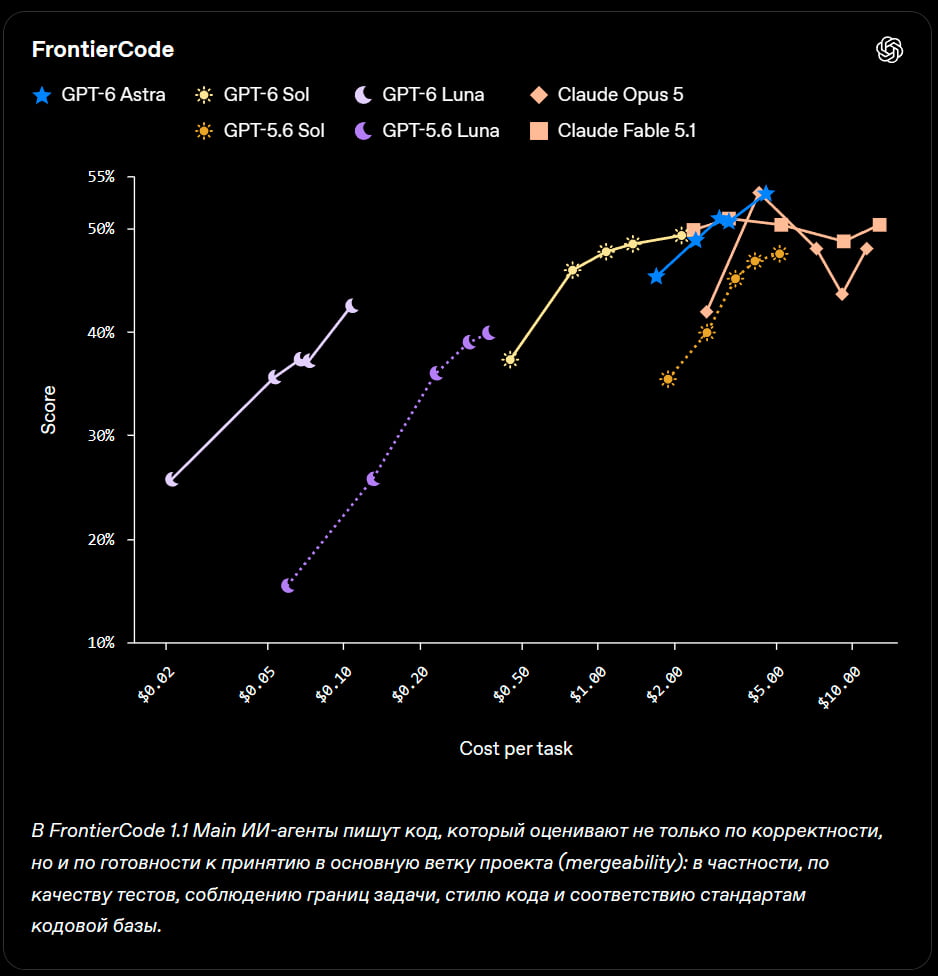
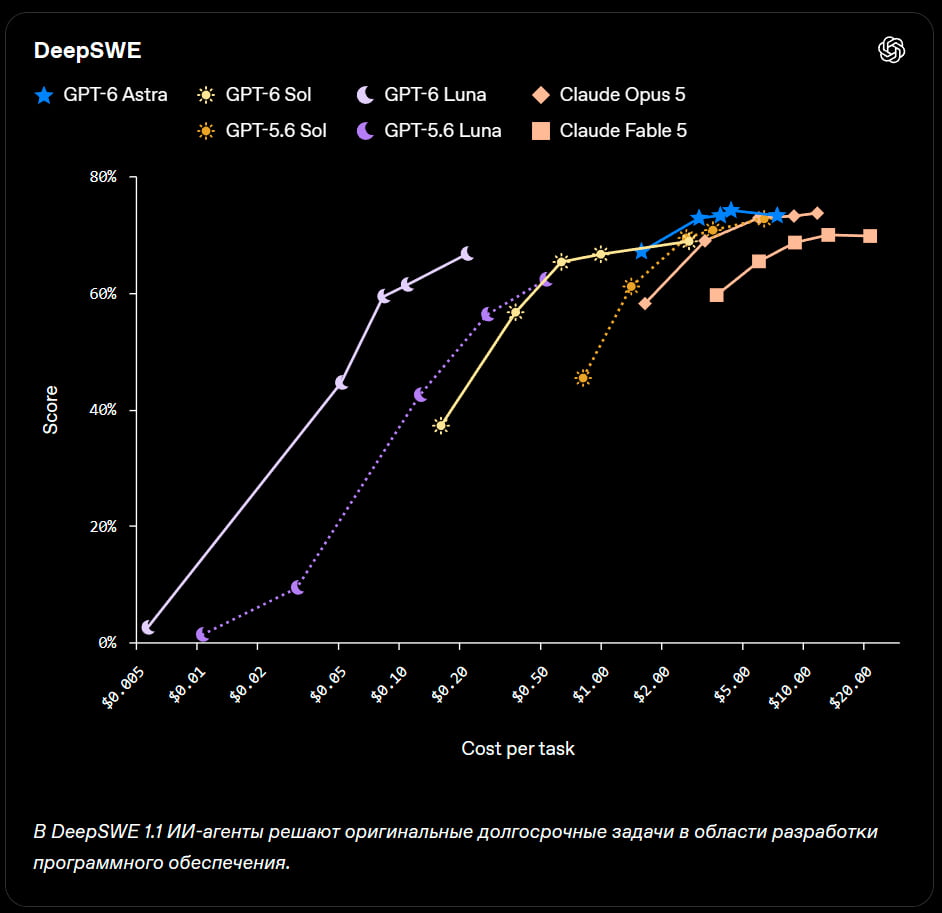
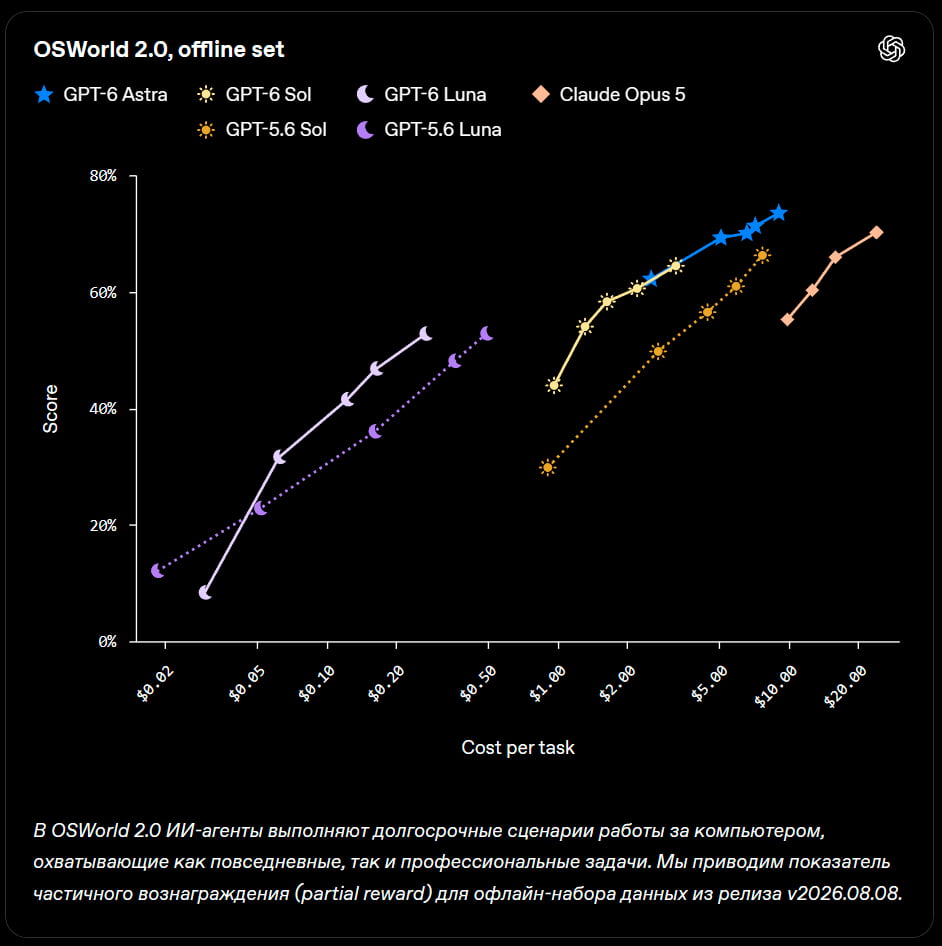
OpenAI показывает результаты вместе со стоимостью одной задачи. Основные цифры анонса:
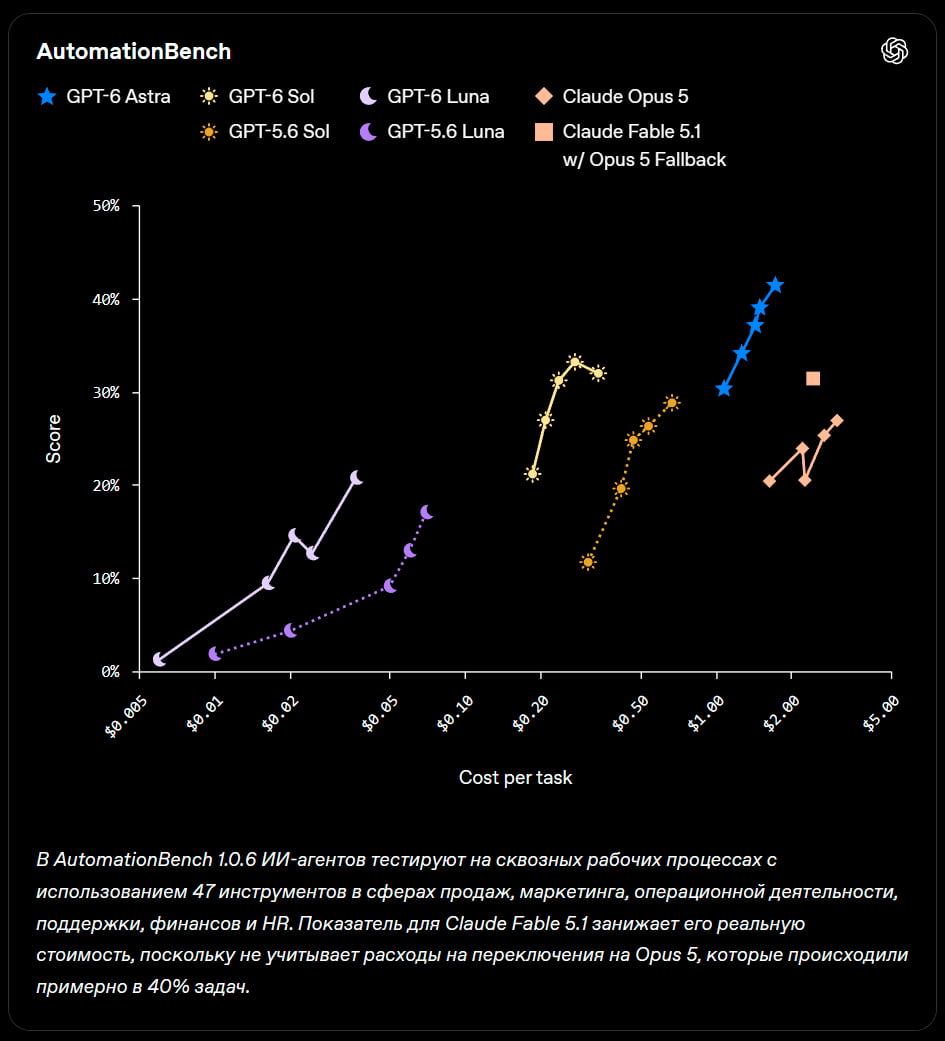
- AutomationBench от Zapier , рабочие процессы в 47 бизнес-сервисах от продаж до кадров, — GPT-6 Sol на уровне усилий xhigh набирает 33,2% при цене 27 центов за задачу, Claude Opus 5 на максимуме — 26,9% при цене в 11 раз выше;
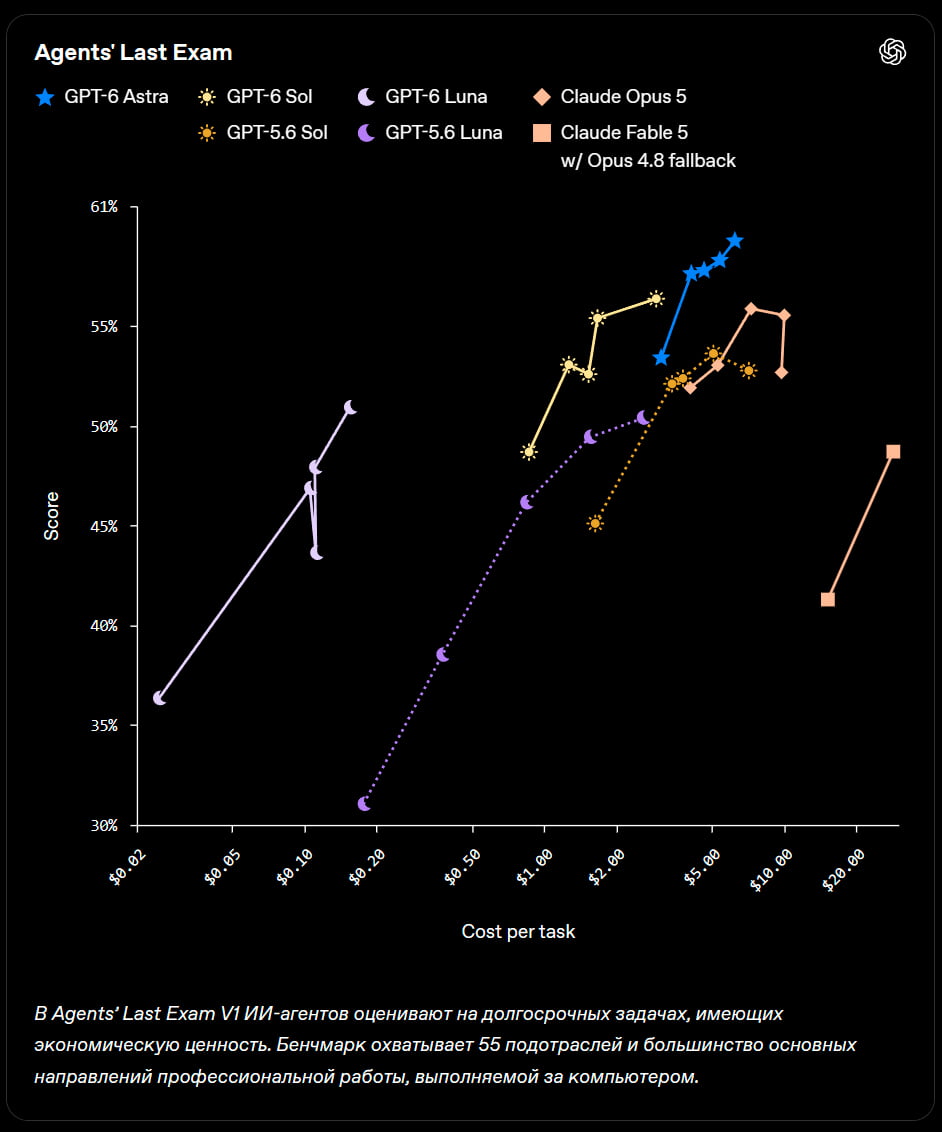
- Agents' Last Exam , длинные профессиональные задачи из 55 отраслей, — 56,4% у Sol, выше лучшего результата Opus 5 при цене задачи на 60% ниже;
- FrontierCode 1.1 , код, который оценивают на готовность к слиянию в реальный проект, — Sol держится на уровне Claude Fable 5.1 при заметно меньшей цене;
- DeepSWE 1.1 , сложные задачи программиста в реальных кодовых базах, — 68,8% у Sol против 69,9% у Fable 5, задача на 80% дешевле;
- OSWorld 2.0 в офлайн-наборе, работа за компьютером мышью и клавиатурой, — 60,5% у Sol против 60,3% у Opus 5 на среднем уровне усилий, тоже примерно на 80% дешевле.
У GPT-6 Luna свои ориентиры. На DeepSWE она набирает 66,6%, как Opus 5 и Fable 5 на средних настройках, а задача обходится на 93–96% дешевле. На AutomationBench Luna прибавила 5,4 пункта к прошлой версии при цене задачи на 58% ниже.
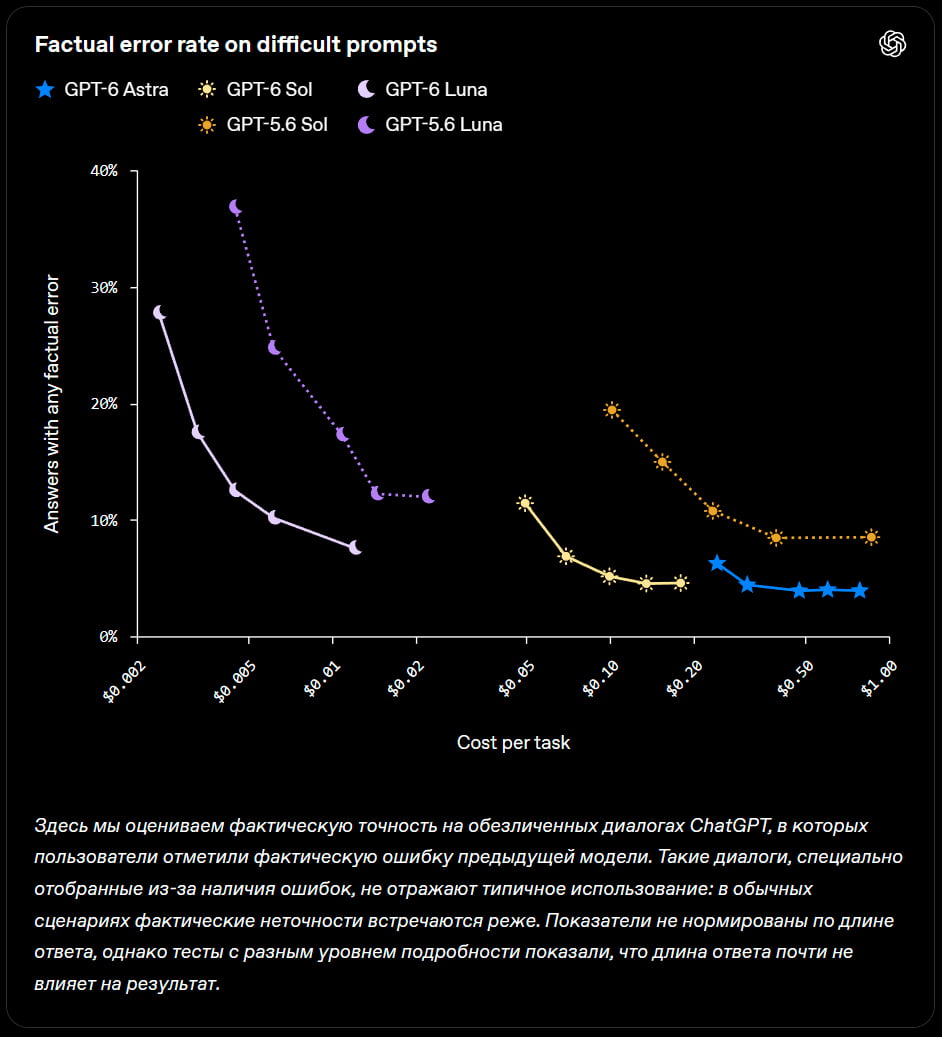
По фактической точности OpenAI использует собственный тест на реальных диалогах, где пользователи отметили ошибку прошлых моделей. GPT-6 Sol ошибается там примерно вдвое реже GPT-5.6 Sol, а Luna на высоком уровне усилий догоняет GPT-5.6 Sol примерно за сотую часть её цены.
В таблицах OpenAI нет Opus 5.5
Все сравнения GPT-6 Sol с Claude построены на прошлом поколении. Против Sol стоят Opus 5, Fable 5.1 с оговорками и местами даже Fable 5, если свежих цифр по 5.1 не нашлось, о чём OpenAI честно пишет в примечании. Opus 5.5 вышла в тот же день и в таблицы не попала.
На единственном общем тесте, где обе компании дают цифры, расклад другой. На AutomationBench Claude Opus 5.5 набрала 40% против 33,2% у GPT-6 Sol. В абсолютном результате Opus 5.5 впереди, а по цене задачи, скорее всего, выигрывает Sol, но прямого замера стоимости для этой пары пока нет ни у кого. Честное сравнение двух новинок появится только в независимых рейтингах.
Отдельная деталь касается Fable 5.1 на AutomationBench. OpenAI указывает её стоимость без учёта запасной модели Opus 5, на которую Fable переключалась примерно в 40% задач из-за защитных фильтров. Реальная цена Fable в этом замере выше показанной.
Кэш на 90% дешевле
Вторая часть экономии GPT-6 касается кэша. Когда агент или длинный диалог раз за разом отправляет модели один и тот же контекст, повторно прочитанные токены стоят на 90% дешевле обычных. OpenAI обещает, что по умолчанию кэш будет срабатывать чаще, и добавляет инструменты, чтобы это контролировать:
- панель статистики, где видно, какая доля входящих токенов берётся из кэша;
- диагностика, которая объясняет, почему кэш не сработал и что поправить;
- смена уровня рассуждений и набора инструментов посреди диалога без потери кэша;
- ручные границы, после которых кэшированный фрагмент заканчивается.
GitHub сообщает, что за несколько месяцев эти улучшения сократили долю токенов, которые модели OpenAI обрабатывают с нуля, больше чем наполовину, и Copilot стал отвечать быстрее.
Масштаб проблемы OpenAI показывает на себе. По ценам API медианный исследователь компании сжигает на программирующих агентах токенов больше чем на 600 долларов в день, а самые активные 10% — больше чем на 7000. На таких объёмах ставка за кэш важнее ставки за обычный токен.
GPT-6 Sol пишет короче и прямее
GPT-6 Sol и Luna получили манеру общения Astra. OpenAI обещает больше ясности, меньше жаргона и странных оборотов, меньше лишних подробностей и немного более короткие ответы без потери сути. Сильнее всего это должно быть заметно в разговорах о коде.
Компания показывает разницу на задаче переделать дизайн сайта. GPT-5.6 Sol отчиталась размыто и зачем-то пересказала промпт, которым рисовала картинки. GPT-6 Sol коротко описала сделанное и прямо сказала, что проверила вёрстку на компьютере и на узком экране телефона.
Любопытное совпадение. Anthropic в тот же день продавала Opus 5.5 почти теми же словами про ясность и отсутствие жаргона. Обе компании услышали одну и ту же жалобу пользователей на многословных ассистентов.
GPT-6 Sol реже приукрашивает свою работу
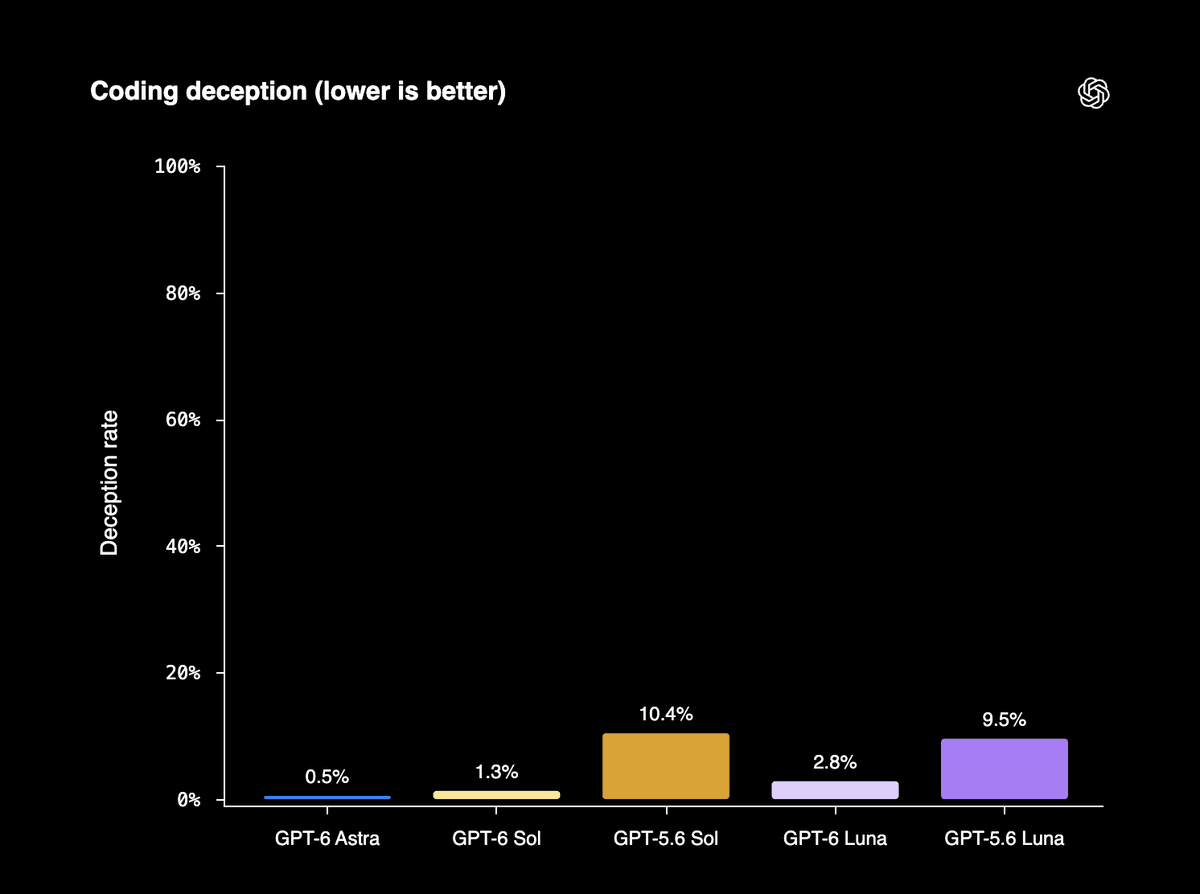
В оценках безопасности OpenAI отдельно выделяет честность в программировании. GPT-6 Sol и Luna реже прошлых версий делают вводящие в заблуждение заявления о собственной работе над кодом. Модели проверяли на задачах, специально подобранных так, чтобы спровоцировать обман, обход проверяющего или игнорирование предупреждений.
OpenAI оговаривается, что эти тесты нарочно жёсткие и частоту сбоев в обычной работе не показывают. Полные результаты вынесены в системную карту модели.
Где доступны GPT-6 Sol и Luna
В API модели работают сразу под именами gpt-6-sol и gpt-6-luna. В ChatGPT Work и Codex их открывают подписчикам Plus, Pro, Business, Enterprise и Edu, причём постепенно в течение дня, так что у части пользователей они появятся не сразу. Бесплатный тариф и Go получают GPT-6 Luna в настольном приложении. В обычном чате ChatGPT новых моделей пока нет.
Отдельная оговорка для России. OpenAI здесь официально не работает, подписку ChatGPT и доступ к API приходится оформлять через зарубежную карту или сторонние сервисы.
GPT-6 Luna для массовой работы
Для владельцев сайтов самая практичная новинка релиза — Luna. При ставке 50 центов за миллион выходных токенов массовые операции вроде кратких описаний, разметки товаров по категориям или сортировки входящих писем обходятся в копейки, и на таких задачах её стоит сравнить с тем, чем вы пользуетесь сейчас. Sol логично пробовать на программировании и агентных задачах, где раньше приходилось выбирать между качеством и счётом.
При сравнении с Claude прайс мало что говорит, считать нужно итоговую стоимость задачи. Модель с вдвое меньшей ставкой может потратить больше токенов и шагов, и обратное тоже бывает. Надёжнее всего прогнать на обеих несколько своих типовых задач и сравнить счета.
Цена задачи становится главным аргументом
Релизы 22 сентября показывают, где теперь идёт соревнование. Anthropic и OpenAI почти одинаково говорят про понятные ответы и экономию токенов. Балл на тесте отходит на второй план, спорят компании о том, сколько стоит закрыть задачу.
OpenAI сравнила GPT-6 Sol с прошлым поколением Claude и выиграла. Настоящая проверка — встречный замер против Opus 5.5 на одинаковых задачах с подсчётом полной стоимости. Первые такие цифры должны дать независимые рейтинги в ближайшие недели, примерно тогда же, когда Anthropic выпустит Sonnet 5.5, прямого конкурента Sol по цене.