Anthropic выпустила Claude Opus 5.5 - уровень Fable за меньшие деньги
Claude Opus 5.5 открывает семейство Claude 5.5 и сразу становится моделью, которую Anthropic советует брать по умолчанию для большинства рабочих задач. Компания подаёт релиз через экономику. Модель почти догнала верхнюю Fable 5.1 , стала быстрее и дешевле предшественницы, а заодно научилась писать понятнее. Opus 5.5 уже работает в приложениях Claude, в API и на облачных площадках Amazon, Google и Microsoft.
Opus 5.5 обогнала старшую модель на переписывании кода
Самый наглядный пример в анонсе касается HAProxy , популярной программы, которая распределяет веб-трафик между серверами. Anthropic поручила Opus 5.5 и Fable 5.1 перевести её код с языка C на Rust. Обе версии прошли почти все собственные регрессионные тесты HAProxy, то есть проверки, что после правок ничего не сломалось. Opus 5.5 справилась за 9,5 часа против 12 у Fable 5.1 и потратила на 51% меньше денег.
Остальные примеры из той же категории долгих и разлапистых задач. Один из ранних тестировщиков провёл на Opus 5.5 миграцию кодовой базы в 680 тысяч строк меньше чем за сутки, хотя команде инженеров на это понадобились бы недели. Другой за три часа проверил и исправил проект на 200 тысяч строк, где Opus 5 провозилась больше 20 часов и сожгла в два с половиной раза больше токенов. Когда модель попросили ускорить загрузку всех страниц веб-приложения, она справилась в 39 случаях из 40, а Opus 5 добивалась меньшего прироста и попутно меняла поведение приложения.
Здесь нужно оговориться. Все эти случаи собрала сама Anthropic из собственных тестов и отзывов партнёров по раннему доступу, перепроверить их со стороны пока нельзя.
Место Opus 5.5 в линейке Claude
У Claude сейчас четыре ступени, и Opus 5.5 встала на вторую сверху. Ставки API за миллион токенов на входе и выходе выглядят так:
- Haiku 4.5 — 1 и 5 $, самая быстрая модель для простых объёмных задач;
- Sonnet 5 — 2 и 10 $, баланс скорости и качества;
- Opus 5.5 — 4 и 20 $, долгий агентный кодинг и работа с документами и данными;
- Fable 5.1 — 10 и 50 $, самые тяжёлые рассуждения и многочасовая автономная работа.
В документации Anthropic прямо рекомендует начинать с Opus 5.5 и переходить на Fable 5.1 только тогда, когда Opus на высоких настройках не вытягивает задачу. Для компании, которая месяц назад выпустила верхнюю модель, это смелое признание. Средняя ступень теперь дотягивается до верхней за две пятых её цены.
Бенчмарки Opus 5.5 против Fable и OpenAI
Anthropic сравнивает Claude Opus 5.5 с Fable 5.1, Opus 5 и двумя моделями OpenAI . Результаты сняты на максимальном уровне усилий, если не указано иное:
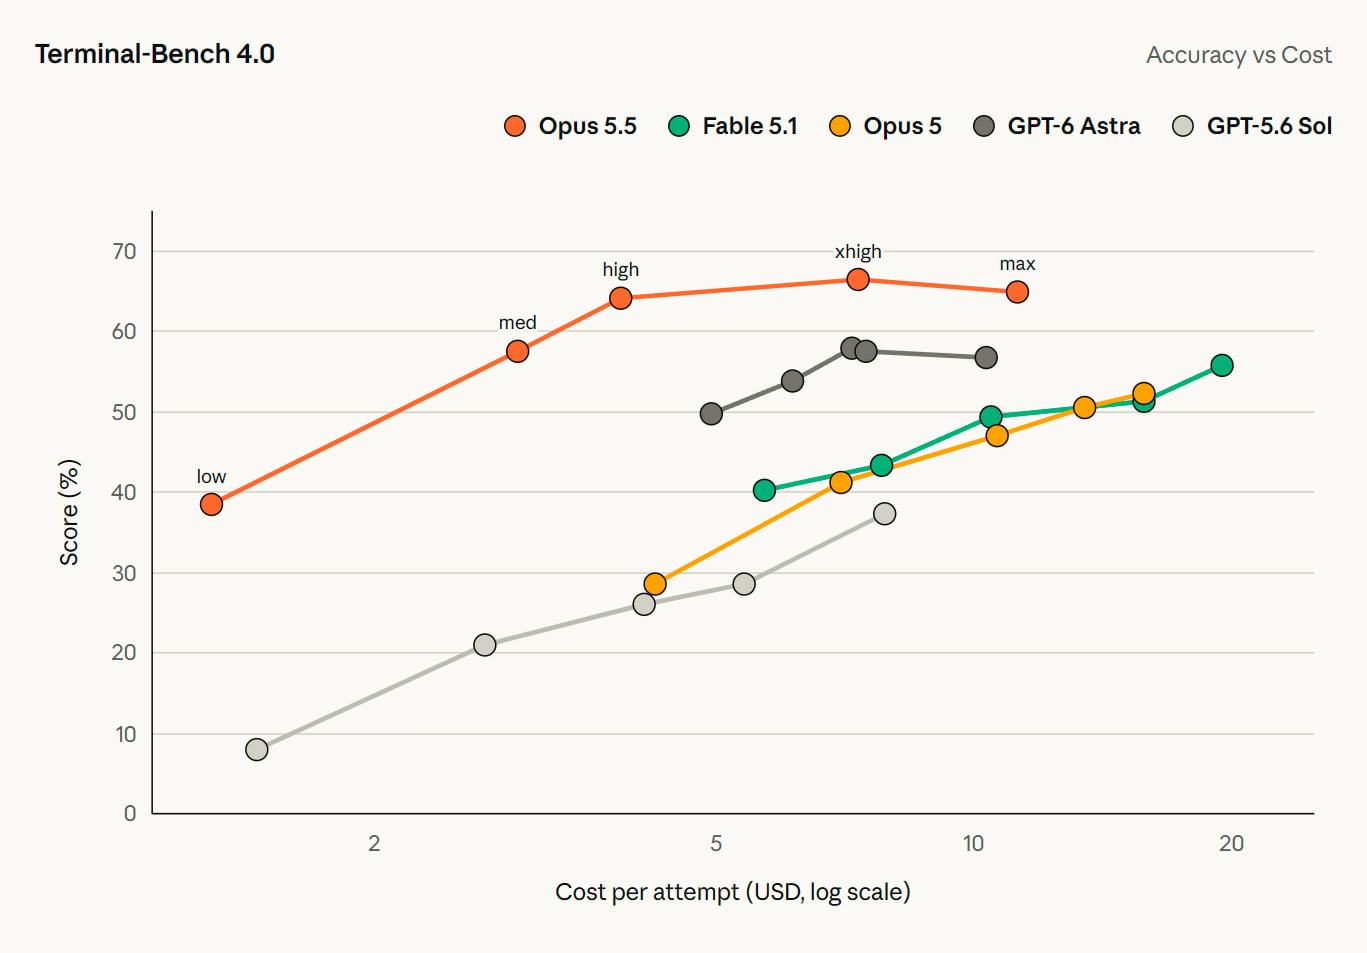
- Terminal-Bench 4.0 , многошаговые задачи программиста в командной строке, — 66,4% против 55,8% у Fable 5.1, 52,3% у Opus 5 и 57,9% у GPT-6 Astra;
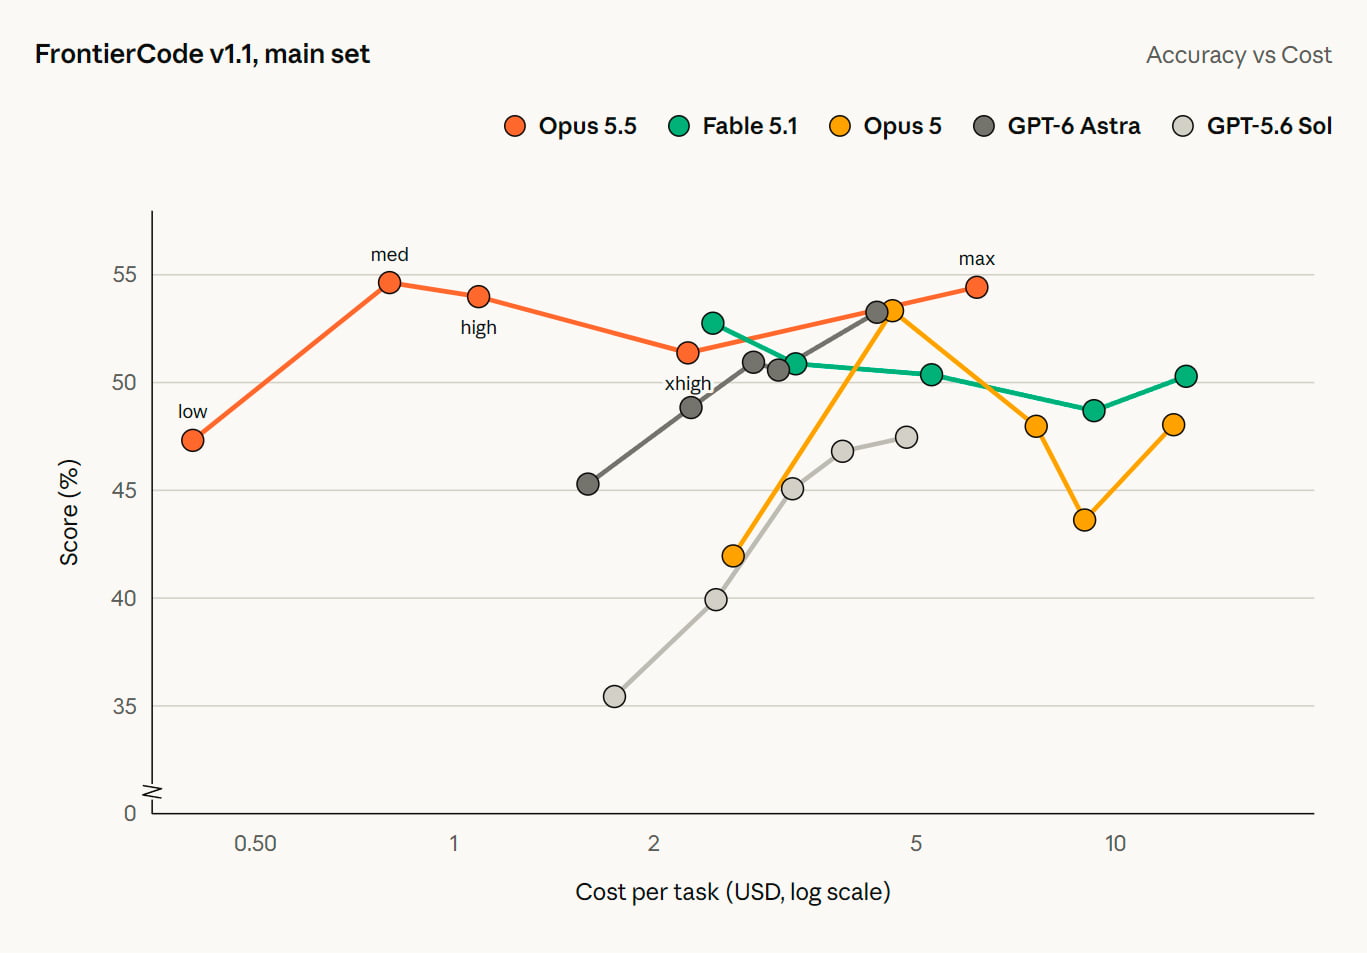
- FrontierCode v1.1 , агентный кодинг на реальных проектах, — 54,4% против 50,3% у Fable и 53,3% у Astra;
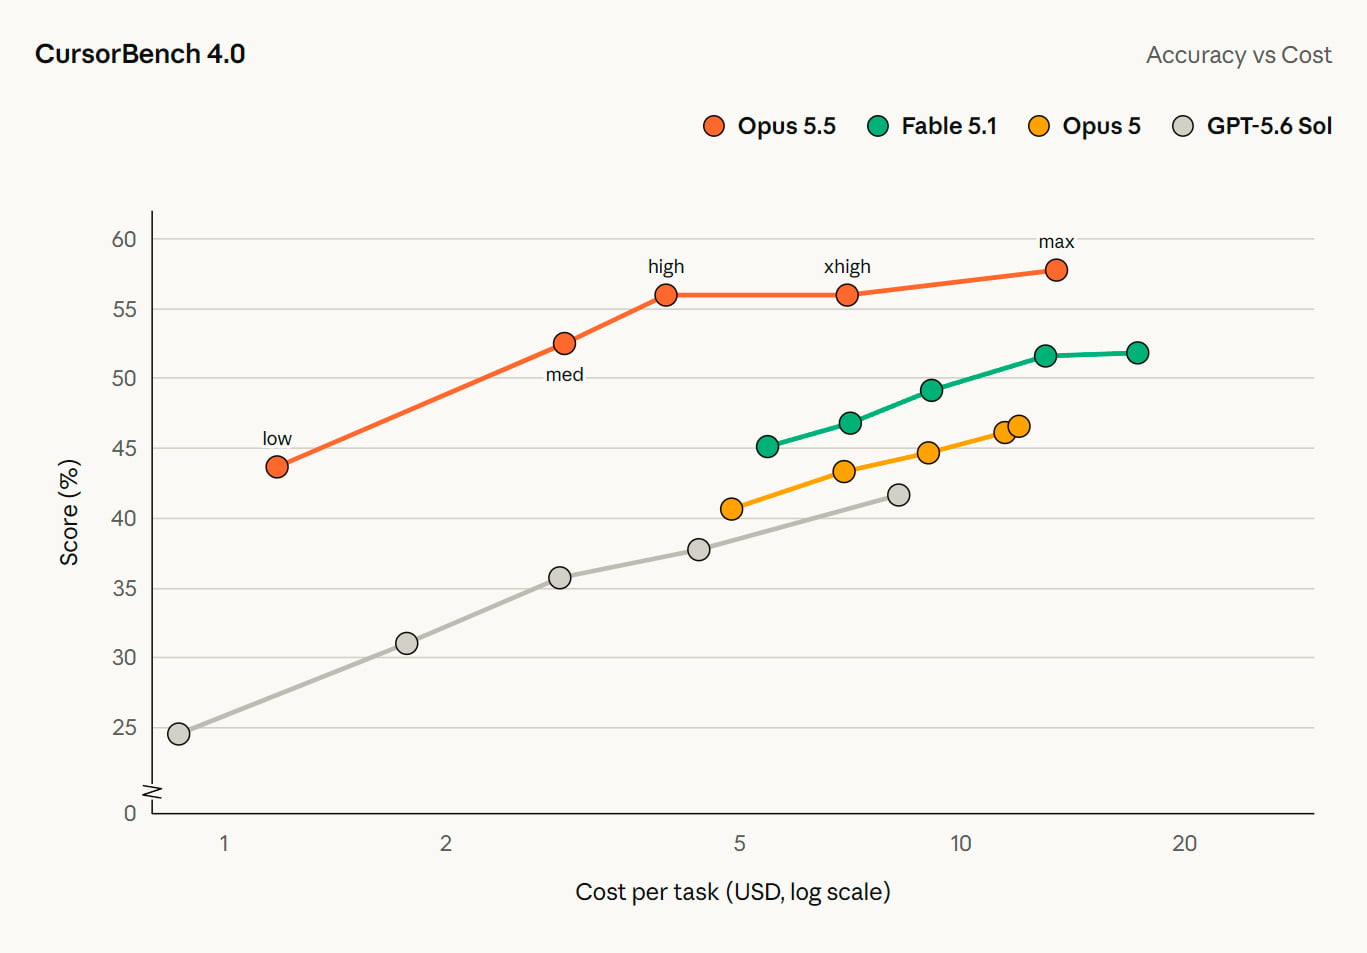
- CursorBench 4.0 , задачи из редактора кода Cursor , — 57,8% против 51,8% у Fable и 41,7% у GPT-5 .6 Sol;
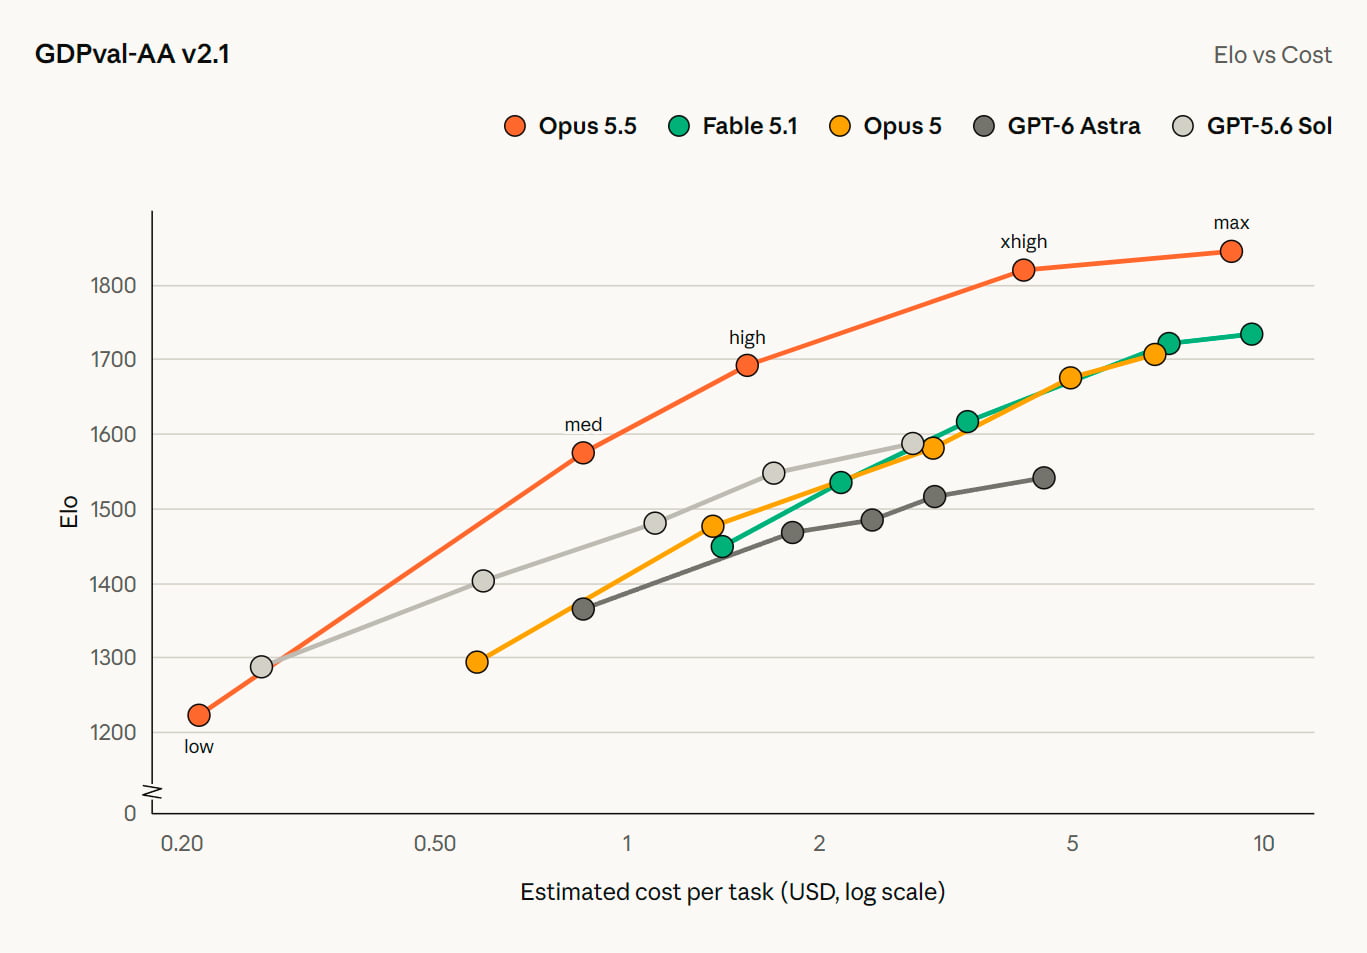
- GDPval-AA v2.1 , профессиональная работа в 44 профессиях с рейтингом Эло, — 1846 очков против 1735 у Fable и 1542 у Astra;
- Humanity's Last Exam с инструментами, вопросы уровня научной аспирантуры, — 67,7% против 65,6% у Fable и 57,2% у Astra;
- OSWorld 2.0 , работа мышью и клавиатурой за компьютером, — 81,8% против 80,7% у Fable и 74% у Opus 5.
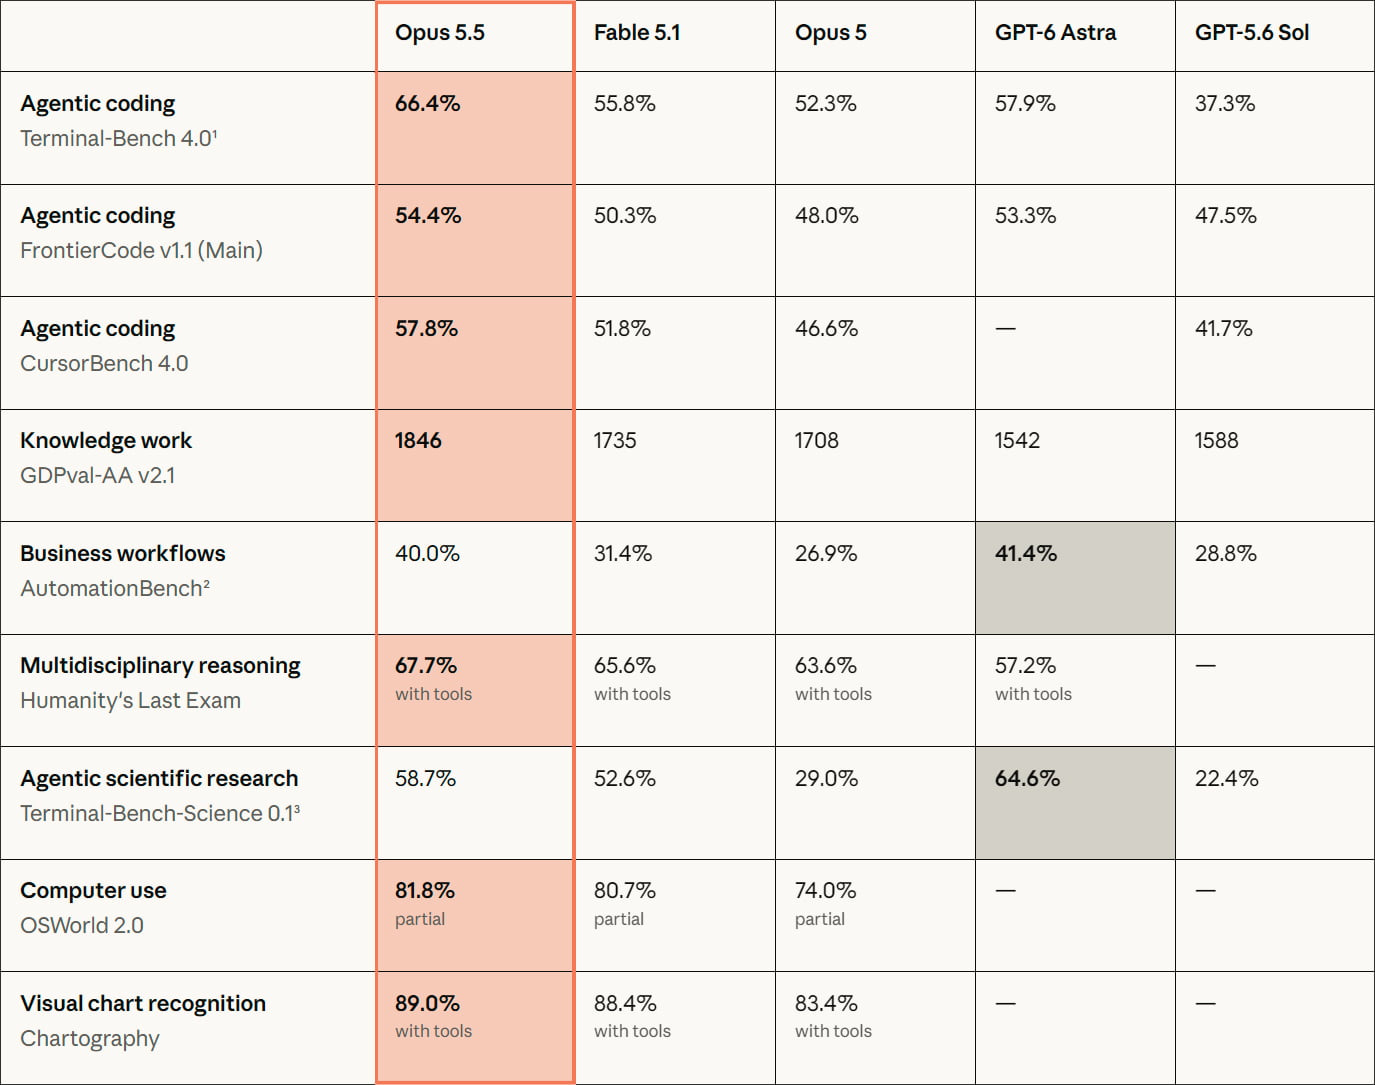
Самый заметный скачок пришёлся на Terminal-Bench 4.0, где Opus 5.5 обошла старшую модель на десять с лишним пунктов. Этот результат снят на уровне усилий xhigh. На эрудиции и работе за компьютером отрыв от Fable укладывается в один-два пункта. Сама Anthropic предупреждает, что на нынешнем уровне моделей разница в бенчмарках всё хуже отражает разницу в реальной работе, и в её собственной практике Opus 5.5 отстаёт от Fable меньше, чем показывают цифры.
Где GPT-6 Astra сильнее
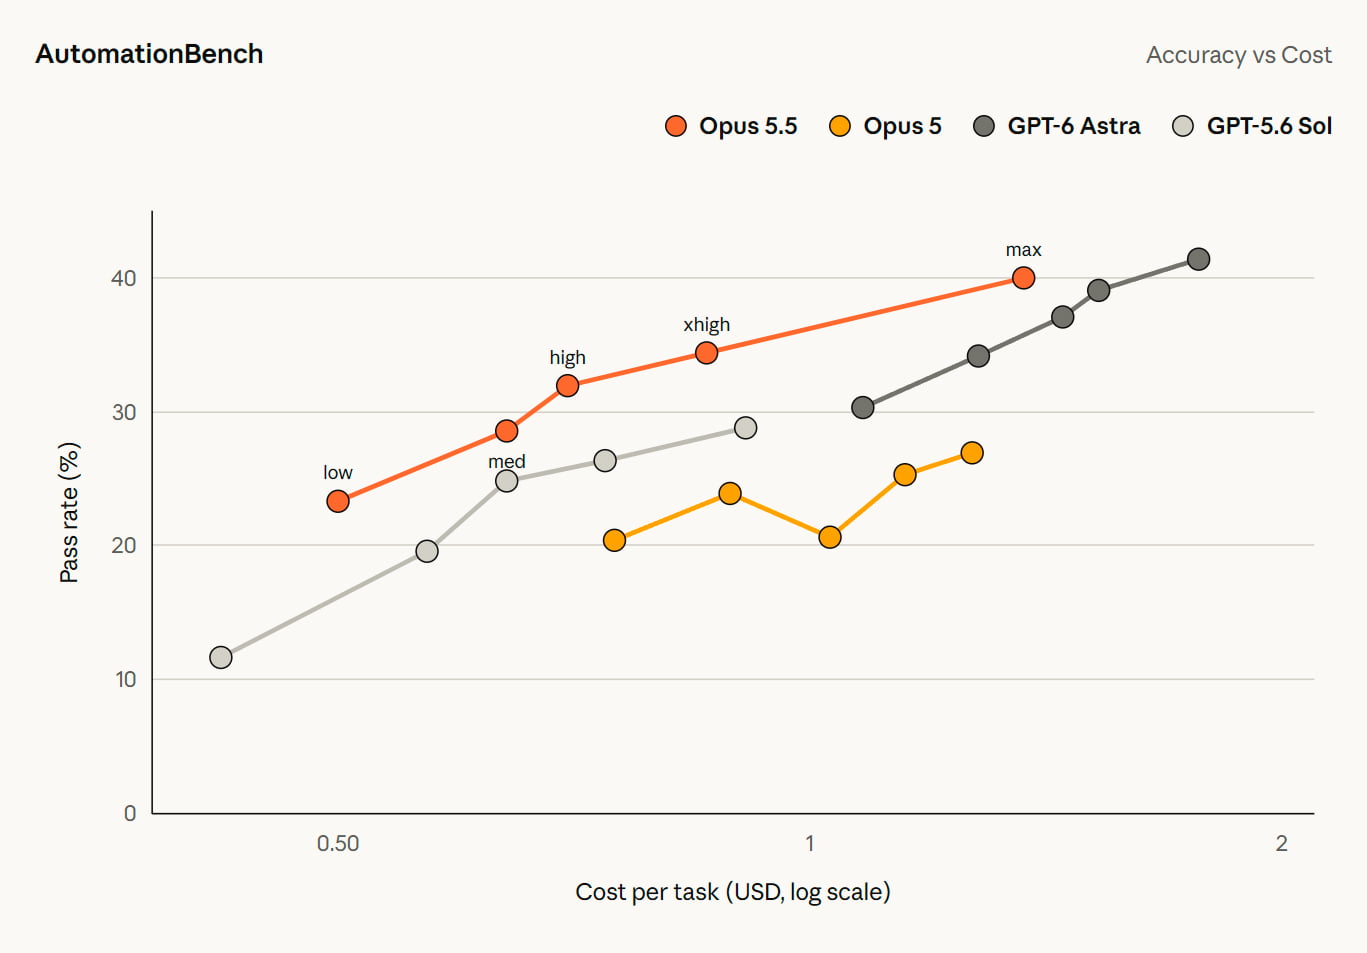
В таблице есть две строки, где Claude Opus 5.5 проигрывает. На AutomationBench, который проверяет рутинные бизнес-процессы вроде переноса данных между сервисами, GPT-6 Astra набрала 41,4% против 40%. На Terminal-Bench-Science 0.1, самостоятельной научной работе в терминале, отрыв Astra заметнее — 64,6% против 58,7%.
У обоих проигрышей есть оговорка. Opus 5.5 тестировали с включёнными защитными фильтрами. Если фильтр срабатывал, задачу по кибербезопасности доделывала Opus 4.8, а задачи по биологии и разработке ИИ-моделей — Opus 5. На AutomationBench такие срабатывания вообще засчитывали как провал, поэтому, по словам Anthropic, в реальной работе результат выше.
Показательно и то, кого в таблице нет. Anthropic сравнивается с OpenAI, но ни одной модели Google в сравнении не оказалось.
Opus 5.5 подешевела на 40%
Базовые ставки Claude Opus 5.5 снизились на 20% — 4 доллара за миллион входных токенов вместо 5 и 20 за миллион выходных вместо 25. Сильнее упала цена чтения из кэша, то есть повторного обращения к уже загруженному контексту. Миллион таких токенов стоит 20 центов вместо 50. По данным Anthropic, именно кэш составляет большую часть счёта в агентной работе и программировании, где модель раз за разом перечитывает одну и ту же историю задачи. Запись в кэш подешевела с 6,25 до 5 долларов.
Вторая часть экономии идёт от самой модели. Opus 5.5 тратит на задачу меньше токенов и шагов, и вместе со снижением ставок это даёт те самые 40% на типичной нагрузке при настройках по умолчанию. Ответы она генерирует больше чем на 30% быстрее Opus 5.
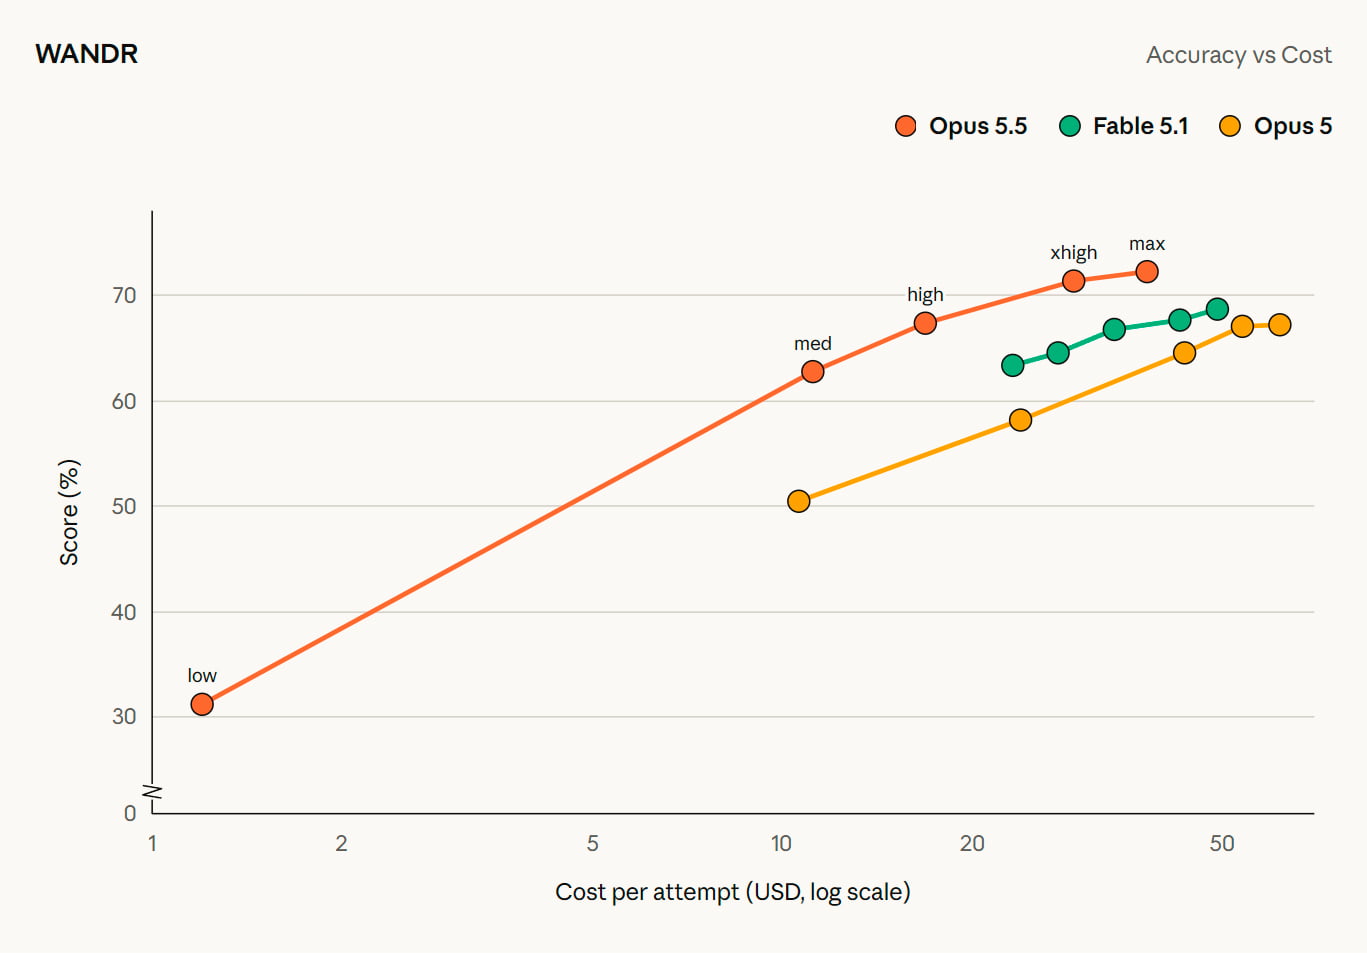
Графики Anthropic переводят это в стоимость решённой задачи. На Terminal-Bench 4.0 Opus 5.5 на уровне усилий по умолчанию обходит Opus 5 на максимальных настройках примерно за пятую часть цены и держится вровень с GPT-6 Astra за 40% её стоимости. На FrontierCode она обходит Astra примерно за 20% цены задачи. По ставкам за токены Opus 5.5 в два с половиной раза дешевле флагманской GPT-6 Astra, которая стоит 10 и 50 долларов за миллион.
Со средней ступенью OpenAI картина другая. В тот же день компания выпустила GPT-6 Sol по 2 и 10 долларов за миллион токенов, то есть вдвое дешевле Opus 5.5 по обеим ставкам. В своих сравнениях OpenAI поставила Sol против прошлой Opus 5, свежую Opus 5.5 в них не включили.
Для тех, кому важна скорость, есть ускоренный режим в Claude Code и на Claude Platform. Он работает до 2,5 раза быстрее и стоит 8 и 40 долларов за миллион токенов.
Opus 5.5 научилась писать понятнее
На манеру письма Opus 5 жаловались чаще всего, и Anthropic признаёт это в анонсе. Claude Opus 5.5 ставит главное в начало ответа, реже уходит в жаргон и странные обороты и лучше соблюдает правила оформления, которые ей задают. Компания показывает разницу на примере разбора ошибки в биллинге. Opus 5 начинает с технических деталей коммита, Opus 5.5 сразу говорит, сколько денег съел баг и почему часть расхода вообще не попадает в счёт.
«Многословный, трудный для восприятия вывод был моим главным раздражителем у передовых моделей, и Claude Opus 5.5 это исправляет. Она пишет как хороший коллега и соблюдает наши правила письма»,
- рассказал Джон Руэлас, ведущий инженер финтех-компании Ramp.
Anthropic видит здесь и пользу для безопасности. Работу модели, которая излагает ход мысли ясно, человеку проще проверить.
Opus 5.5 не выдумывает цифры в отчётах
Самый любопытный тест из области работы с документами касается выдуманных фактов. Opus 5.5, Fable 5.1 и Opus 5 попросили написать отчёт о квартальных результатах компании по копии интернета, где пресс-релиз с цифрами было трудно найти. Автоматический проверяющий сверял каждую цифру и цитату с источниками, и одна выдуманная деталь проваливала отчёт целиком. У Opus 5.5 планку прошли 16 отчётов из 18. Fable 5.1 и Opus 5 не прошли её ни разу.
Похожие результаты приводят партнёры. В Deloitte Claude Opus 5.5 даже на минимальном уровне усилий нашла 72% известных ошибок при проверке кода, тогда как Opus 5 на высоком уровне — 56%. В инвестиционной компании Walleye Capital модель заметила ошибку в самой инструкции к тестовому заданию, сдвиг индексации минут на единицу, и исправила её, хотя предупредила, что потеряет на этом баллы у проверяющего.
Задача с анализом сделки между двумя вымышленными компаниями показывает, как выглядит экономия на практике. Обе модели построили финансовую модель в Excel и сделали по ней презентацию для руководства, выводы совпали. Opus 5.5 уложилась в 63 минуты против 93 у Opus 5, обошлась вдвое дешевле и ошибок не допустила.
Фильтры Opus 5.5 взяты у Fable
В биологии и кибербезопасности Claude Opus 5.5 сопоставима с закрытой Mythos 5.1, поэтому Anthropic впервые выпускает Opus с защитой того же класса, что у Fable 5.1. Искать и исправлять ошибки в собственном коде модель помогает, а большую часть задач по кибербезопасности незаметно для пользователя перебрасывает на прошлую Opus 4.8. То же с биологией. Лаборатории, стартапы и фармацевтические компании могут подать заявку в программу верификации Life Sciences, а специалистов по защите инфраструктуры пустят через программу Cyber Verification в ближайшие недели.
Остальные защитные меры перешли от Fable 5.1 без изменений. Ответы помечаются текстовым водяным знаком по требованию европейского закона об ИИ. Режим рассуждений нельзя отключить. Для API-аккаунтов, созданных 31 августа и позже, действует защита от дистилляции, то есть от попыток вытянуть рассуждения модели для обучения конкурирующей.
Opus 5.5 догадывается, что её проверяют
По внутреннему аудиту поведения, почти двум тысячам смоделированных ситуаций, Opus 5.5 стала самой аккуратной моделью Anthropic на сегодня. Она реже предпринимает трудно обратимые действия и реже выходит за отведённые рамки. В новом тесте на попытки обойти ограничения песочницы Opus 5.5 делала это примерно на 85% реже, чем Opus 5 и Mythos 5.1, причём все попытки были мелкими и модель сама о них сообщала. Защита от промпт-инъекций , вредных инструкций, спрятанных в тексте страниц и документов, по всем замерам не хуже, чем у Opus 5.
Самое честное признание в разделе о безопасности касается самих проверок. Anthropic замечает признаки того, что Opus 5.5 часто подозревает, что находится на проверке. Если модель ведёт себя на экзамене иначе, чем в реальной работе, хорошие оценки аудита говорят о ней меньше, чем хотелось бы. Компания признаёт, что с ростом возможностей проблема будет только расти, и делает ставку на интерпретируемость, изучение того, что происходит внутри нейросети.
Opus 5.5 стала первым релизом после того, как глава Anthropic Дарио Амодеи призвал сдерживать гонку возможностей, чтобы меры безопасности успевали за моделями. До выпуска модель проверили внешние организации, в том числе METR и Frontier Design.
Opus 5.5 в API: что учесть при переезде
В API модель называется claude-opus-5-5. Контекст вмещает миллион токенов, ответ может занимать до 128 тысяч, знания модели доходят до июня 2026 года. На вход она принимает текст и изображения.
Главное изменение для тех, кто переезжает с Opus 5, касается уровня усилий по умолчанию. У Opus 5 он был высоким, у Opus 5.5 — средним. Если в коде не задан уровень явно, модель будет думать меньше, и часть задач поменяет поведение. Режим адаптивных рассуждений включён всегда, отключить его нельзя, а новым аккаунтам нельзя редактировать прошлые ходы диалога вместе с рассуждениями модели.
Где попробовать Claude Opus 5.5
Opus 5.5 доступна в веб-версии и приложениях Claude, в Claude Code, через Claude Platform и на площадках Amazon Web Services, Google Cloud и Microsoft Azure. Для корпоративных клиентов, как и у прошлых Opus, есть режим нулевого хранения данных.
Подписчикам Pro, Max, Team и Enterprise с оплатой за места подняли пятичасовые лимиты использования. Вдобавок каждый получил разовый сброс лимита, который можно сохранить и потратить в удобный момент, например перед большой задачей.
Отдельная оговорка для России. Anthropic здесь официально не работает и подписки не продаёт, поэтому доступ к Claude приходится оформлять через зарубежную карту или сторонние сервисы, а программы верификации для российских организаций закрыты.
Opus 5.5 как модель по умолчанию
Тем, кто платит за API из своего кармана, есть смысл начать со среднего уровня усилий и поднимать его только по конкретным задачам. Партнёры Anthropic в один голос пишут, что низкий уровень у Opus 5.5 часто догоняет высокий у Opus 5. Fable 5.1 при таком раскладе остаётся для самых тяжёлых многочасовых прогонов без присмотра, а простую массовую работу по-прежнему дешевле отдать Sonnet или Haiku.
Для длинных агентных задач Anthropic и тестировщики советуют прямо описывать финишную черту, например «все тесты проходят», и просить модель проверять собственную работу. Opus 5.5 лучше предшественниц раздаёт подзадачи дополнительным агентам, и эту способность стоит использовать.
Sonnet 5.5 покажет, насколько подешевеет Claude
Opus 5.5 закрывает две главные претензии к прошлой версии — дорогие долгие прогоны и тяжёлый для чтения текст. Обе цифры пока взяты из замеров самой Anthropic и её партнёров, независимые проверки только начинаются.
Ценовое преимущество тоже оказалось коротким. GPT-6 Sol от OpenAI вышла в тот же день и стоит вдвое дешевле. На тех тестах, где цифры есть у обеих моделей, Opus 5.5 пока впереди, но спорить им теперь предстоит ценой за решённую задачу.
Проверочная точка придёт вместе с Sonnet 5.5 и Haiku 5.5, обещанными в ближайшие недели. Если младшие модели получат такой же прирост, средний пользователь Claude почувствует его сильнее, чем от любого флагмана. Пока же неудобный вопрос остаётся за самой Fable 5.1. Кому она нужна по цене в два с половиной раза выше, если сама Anthropic советует начинать с Opus?