Google выпустила Gemini 3.8 Live - голос, который не замолкает во время работы инструментов
Gemini 3.8 Live — новое поколение голосовых моделей Google, которые работают со звуком напрямую, без привычной связки «распознавание речи → текстовая модель → синтез». Компания подаёт релиз как переход от голосового собеседника к рабочему агенту. Модель слышит речь, смотрит на картинку с камеры и одновременно ходит во внешние сервисы. Раскатка идёт сразу по нескольким продуктам, от Gemini API до Поиска.
Эскиз и голосовая правка превращаются в React-компонент
Сценарии, которыми Google иллюстрирует релиз, собраны из живых демонстраций. Модель разбирает набросок интерфейса вместе с замечаниями голосом и собирает из них работающий React-компонент. В другом ролике она ведёт онбординг сотрудника, ориентируясь на то, что видит на экране, а в третьем играет в шахматы, узнавая позицию на доске в почти реальном времени.
Отдельная линия демонстраций — многошаговые бронирования. Gemini 3.8 Live координирует несколько асинхронных вызовов сразу и по ходу рассказывает, на каком шаге находится. Ещё два примера — сборка бизнес-плана и маркетингового набора голосом, а также пошаговый разбор поломки в Search Live.
Подбор сценариев показывает приоритет Google. В демонстрациях идут рабочие операции — приём новичка, бронирование, разбор неисправности.
Модель говорит и рассуждает одновременно
Главное техническое изменение — асинхронные вызовы функций. Модель подтверждает запрос вслух, уходит выполнять вызов API в фоне и продолжает разговор, пока задача доделывается. Версия Extended Thinking дополнительно проговаривает прогресс и использует ранние вербальные маркеры вроде «Let me check that…», чтобы пауза не превращалась в тишину.
Языков заявлено 97, переключение между ними происходит прямо посреди разговора и без ручной настройки. Отдельно обещана точность на буквенно-цифровых данных — кодах подтверждения, номерах заявок, артикулах. Визуальный вход обрабатывается в почти реальном времени, но конкретных задержек в миллисекундах Google не приводит нигде.
Обе модели построены на базе Gemini 3 Pro. Контекст на входе — до 128 тысяч токенов, на выходе 64 тысячи. Дата отсечки знаний указана в карточке модели как январь 2025 года, то есть на момент выхода разрыв составляет больше двадцати месяцев.
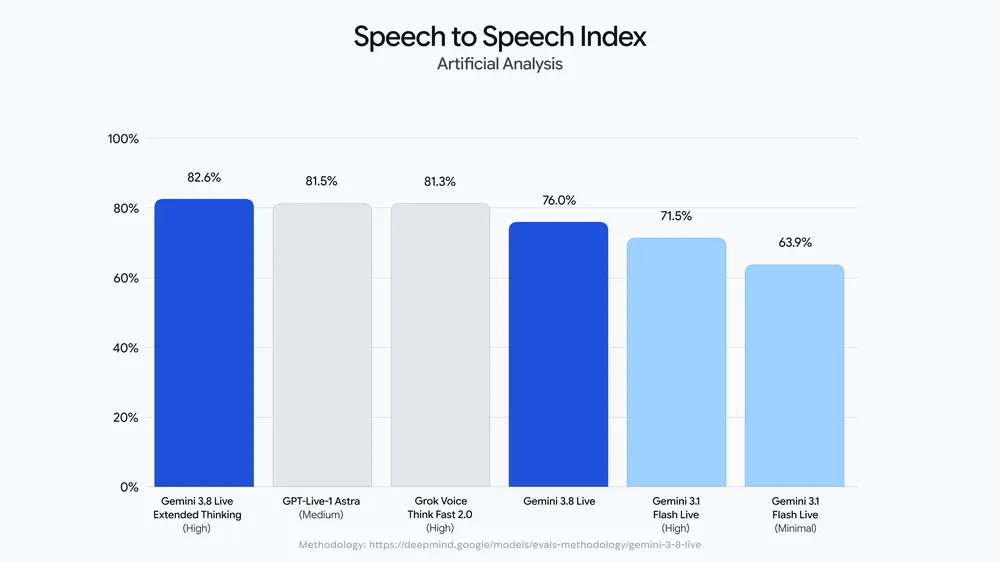
82,6 балла и первое место на Speech-to-Speech
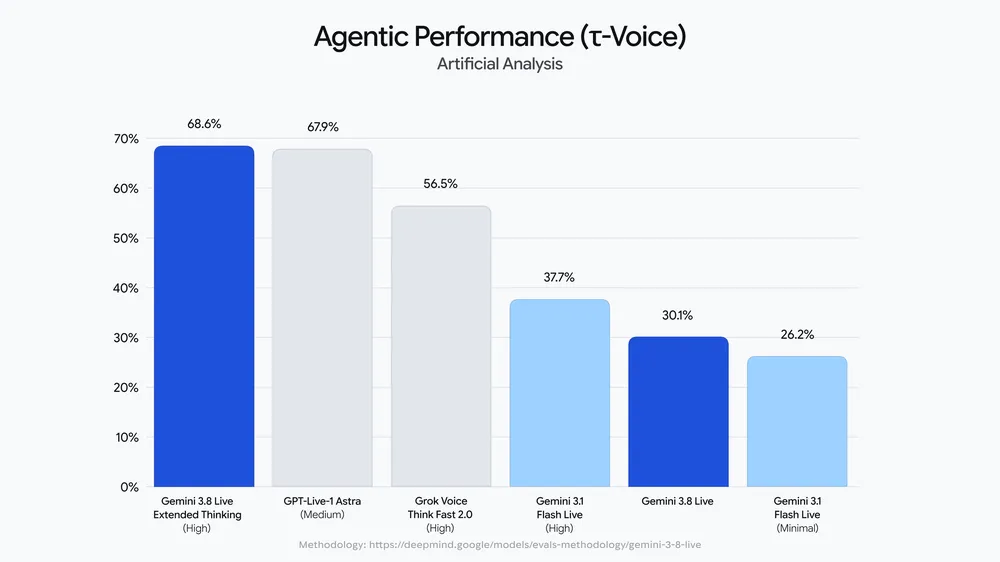
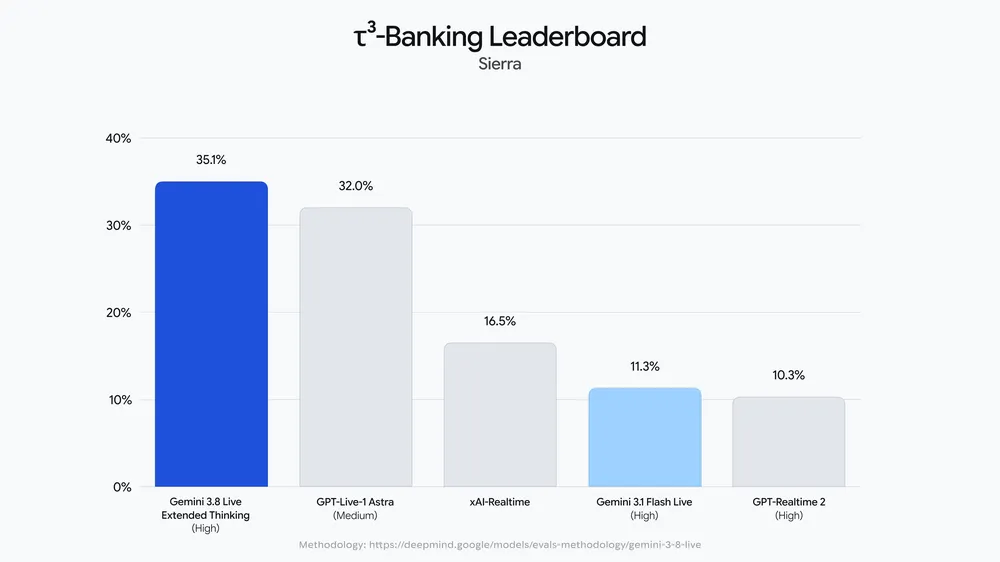
Цифры Google приводит в основном для старшей версии. Gemini 3.8 Live Extended Thinking занимает первое место в индексе Artificial Analysis Speech to Speech Quality с результатом 82,6, набирает 68,6% на агентном τ-Voice, 35,1% на банковском срезе Sierra τ-Voice-banking и 97,7% на Big Bench Audio.
Младшей модели досталась одна строчка — второе место в Speech Agent Arena, без балла. На ServiceNow EVA-Bench вместо чисел показан график, и к нему есть оговорка. Прогон делался на Live API внутри Gemini Enterprise Agent Platform, а не в общедоступной конфигурации. Соперники по замерам не названы ни разу, даты прогонов тоже.
Полцента за минуту входящего звука
Тариф Live API — 0,005 доллара за минуту входящего аудио и 0,018 доллара за минуту исходящего. В сноске Google уточняет, что это оценка, выведенная из токенной цены: 3 доллара за миллион входных токенов и 12 долларов за миллион выходных.
Здесь нужно оговориться. Extended Thinking рассуждает в фоне, а отдельной цены на такие токены в анонсе нет, как нет цен для Vertex AI и корпоративной платформы. Одна и та же пара чисел стоит сразу для двух моделей разной тяжести.
Search Live для всех, корпоративный доступ по приглашению
Разработчикам обе модели открыты в Gemini API и Google AI Studio. Слова «общий доступ» Google не использует ни разу, поэтому формально считать API-версию стабильной нельзя.
Пользовательская раскатка разложена по продуктам:
- Search Live — Gemini 3.8 Live для всех;
- Gemini Live — Extended Thinking для всех;
- Google Docs — Extended Thinking для подписчиков Google AI Pro и Ultra;
- Gmail и Keep — для всех подписчиков Google AI;
- Gemini Enterprise — закрытый предварительный доступ для обеих моделей.
Регионы запуска не названы ни для одного продукта. Лимиты по частоте запросов, максимальная длительность сессии и требования к видеопотоку в анонсе тоже отсутствуют.
Голосового помощника на сайт собирают через LiveKit или Vercel
Инфраструктуру реального времени Google отдал партнёрам: Live API уже поддерживают Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel и Vision Agents. Владельцу сайта или небольшой студии это меняет расклад — голосовой ассистент на странице превращается из отдельной разработки в интеграцию, а поминутная цена позволяет прикинуть бюджет до старта.
Авторам стоит помнить и о другом. Весь аудиовыход ИИ-продуктов Google помечается водяным знаком SynthID, поэтому озвучка, сделанная этими моделями, остаётся детектируемой.
Фронтир-оценку проходила другая модель
В карточке Gemini 3.8 Audio есть любопытный абзац. По актуальному Frontier Safety Framework оценивалась Gemini 3.7 Flash, а вывод о безопасности 3.8 Live и Extended Thinking сделан по аналогии — раз заметных новых способностей у них нет, то и опасных порогов они вряд ли достигают.
Для голосового агента, который сам ходит в сервисы и выполняет действия, такая экстраполяция выглядит тонковато. Судить о зрелости релиза можно будет по одному признаку. Когда закрытый предварительный доступ в Gemini Enterprise сменится общим, Google придётся назвать и лимиты, и регионы, и цену корпоративной минуты.