Google выпустила EmbeddingGemma 2 для локального поиска по фото, видео и звуку
EmbeddingGemma 2 относится к моделям эмбеддингов . Такая модель ничего не пишет и не отвечает на вопросы, она превращает фрагмент данных в набор чисел, вектор, и похожие по смыслу фрагменты получают похожие векторы. На этом держатся умный поиск, рекомендации и RAG , когда чат-бот перед ответом подтягивает нужные документы из базы. Первая EmbeddingGemma работала только с текстом и набрала больше 20 миллионов загрузок. Вторая версия, по словам Google DeepMind , стала лучшей открытой мультимодальной моделью эмбеддингов в весе до миллиарда параметров.
Найти кадр в видео голосовой заметкой
Главная новинка EmbeddingGemma 2 в том, что текст, картинки, кадры видео и звук попадают в одно пространство. Запрос можно задать в одном формате, а искать в другом. Google приводит такие сценарии:
- найти нужный момент в видеозаписи по голосовой заметке, без расшифровки речи;
- искать по многочасовым аудиозаписям обычным текстовым запросом;
- искать фото и ролики в галерее прямо по мере набора запроса или по образцу картинки;
- индексировать локальную кодовую базу для семантического поиска и агентов-программистов.
Все вычисления идут на устройстве, данные никуда не отправляются. В паре с языковой моделью Gemma 4 это даёт полностью локальный RAG, где личные документы и записи не покидают смартфон или ноутбук. Google показала и цифры скорости. На MacBook с чипом M5 Pro модель обрабатывает около 27 изображений в секунду, а поиск по готовому индексу укладывается в единицы миллисекунд.
Конструктор на 740 млн параметров
EmbeddingGemma 2 построена на архитектуре Gemma 4 и собрана из модулей. Подключать их можно по необходимости:
- ядро для текста и кода — 270 млн параметров;
- энкодер изображений и видео — 170 млн;
- энкодер звука — 300 млн.
Если приложению нужен только текстовый поиск, лишние модули не грузятся. После квантизации (сжатия весов до 4 или 8 бит) текстовая версия EmbeddingGemma 2 занимает около 191 МБ оперативной памяти на Pixel 11 Pro, полная мультимодальная около 567 МБ.
Контекстное окно выросло вчетверо, до 8192 токенов. В него помещается примерно 5,5 минуты аудио, 29 изображений или 58 кадров видео. На выходе модель даёт вектор длиной 768 чисел. Технология Matryoshka Representation Learning позволяет обрезать его до 512, 256 или 128 чисел, и векторная база тогда занимает в шесть раз меньше места.
Код вырос на десять пунктов, текст остался на месте
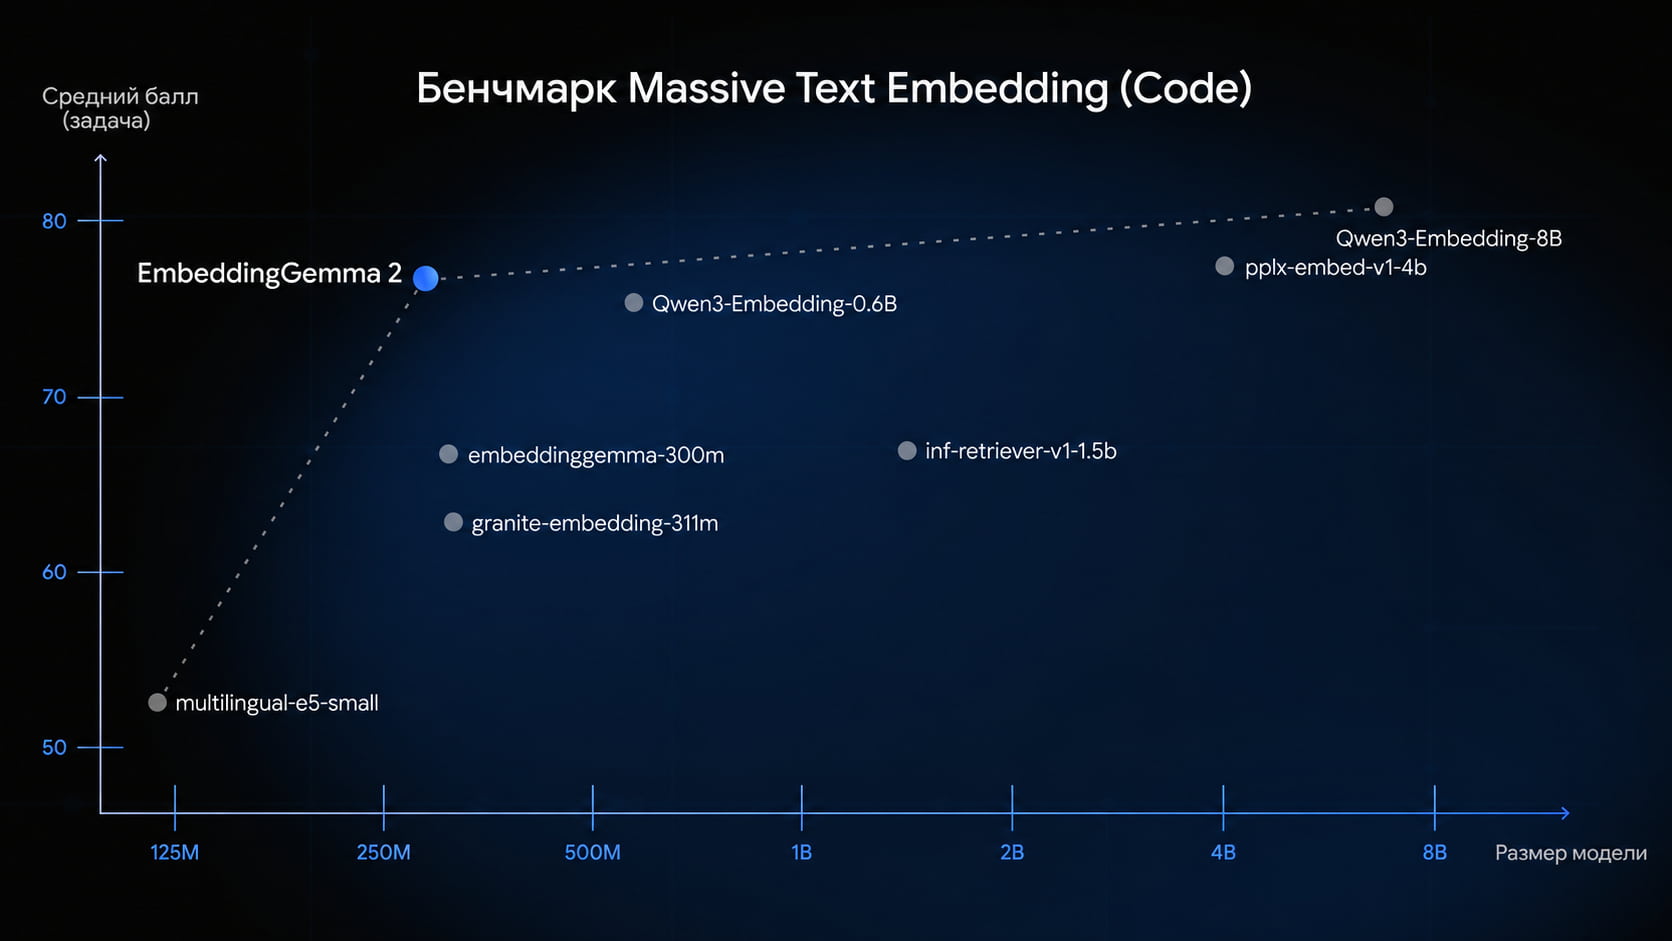
В тестах на поиск по коду (MTEB Code) EmbeddingGemma 2 набрала 78,68 балла против 68,76 у предшественницы. На многоязычном тексте (MTEB Multilingual) прирост символический, 61,36 против 61,15. Новые модальности Google оценивает по нескольким наборам:
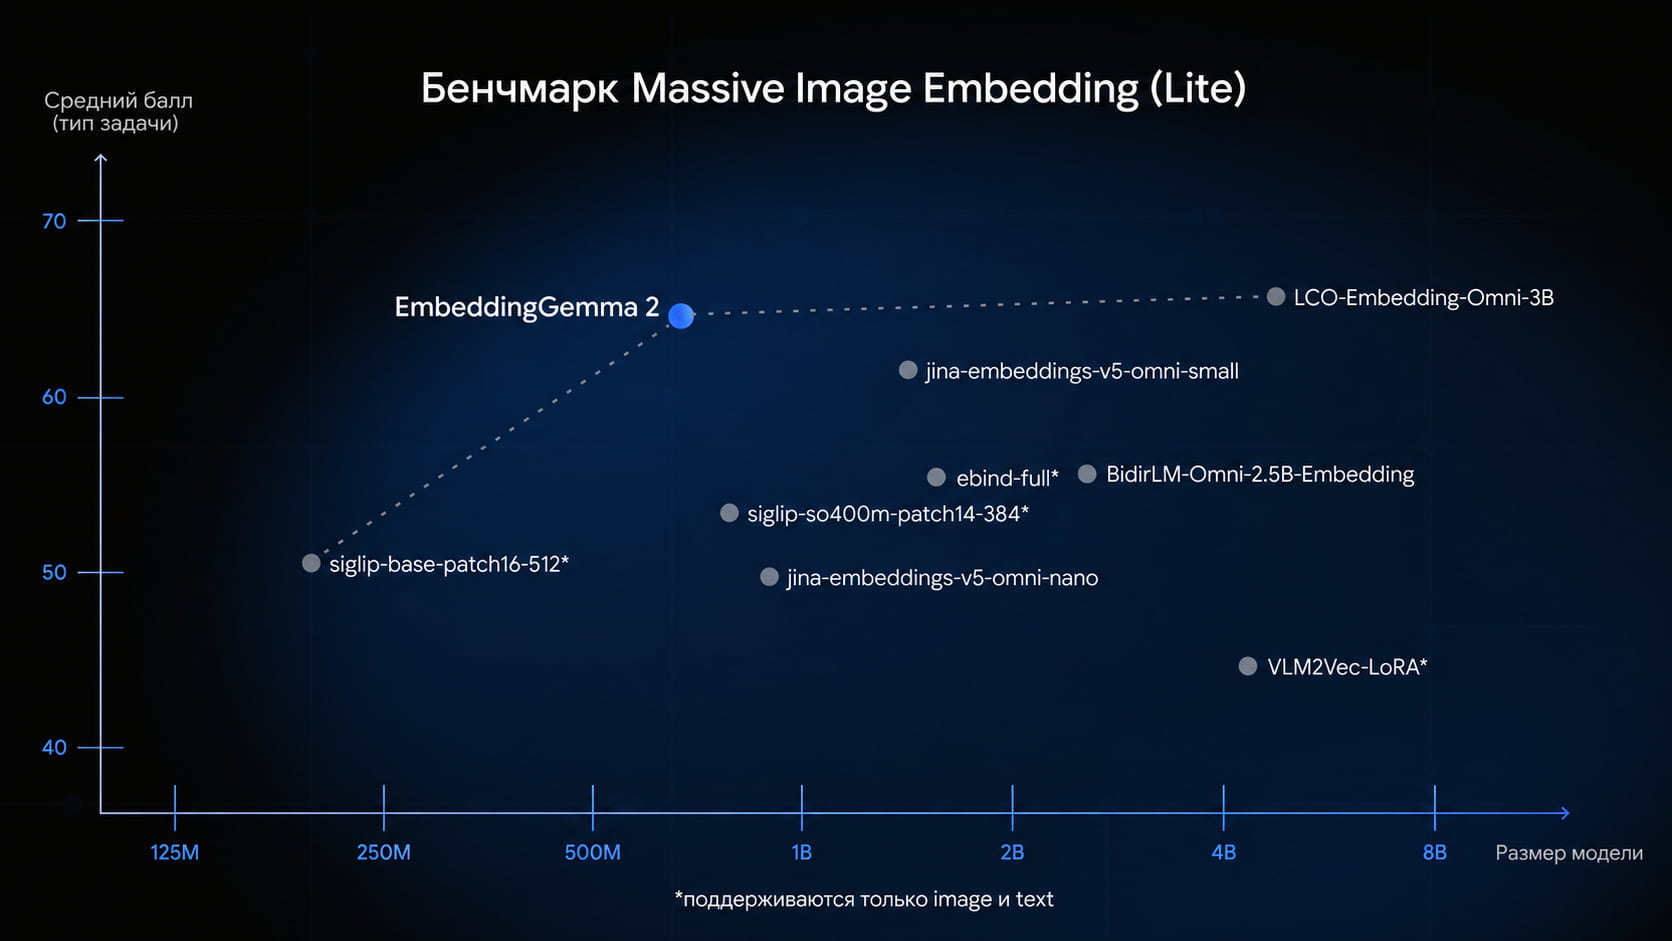
- поиск изображений (MMEB v2) — 57,28;
- поиск по документам со сканами и графиками — 67,84;
- поиск видео — 50,67;
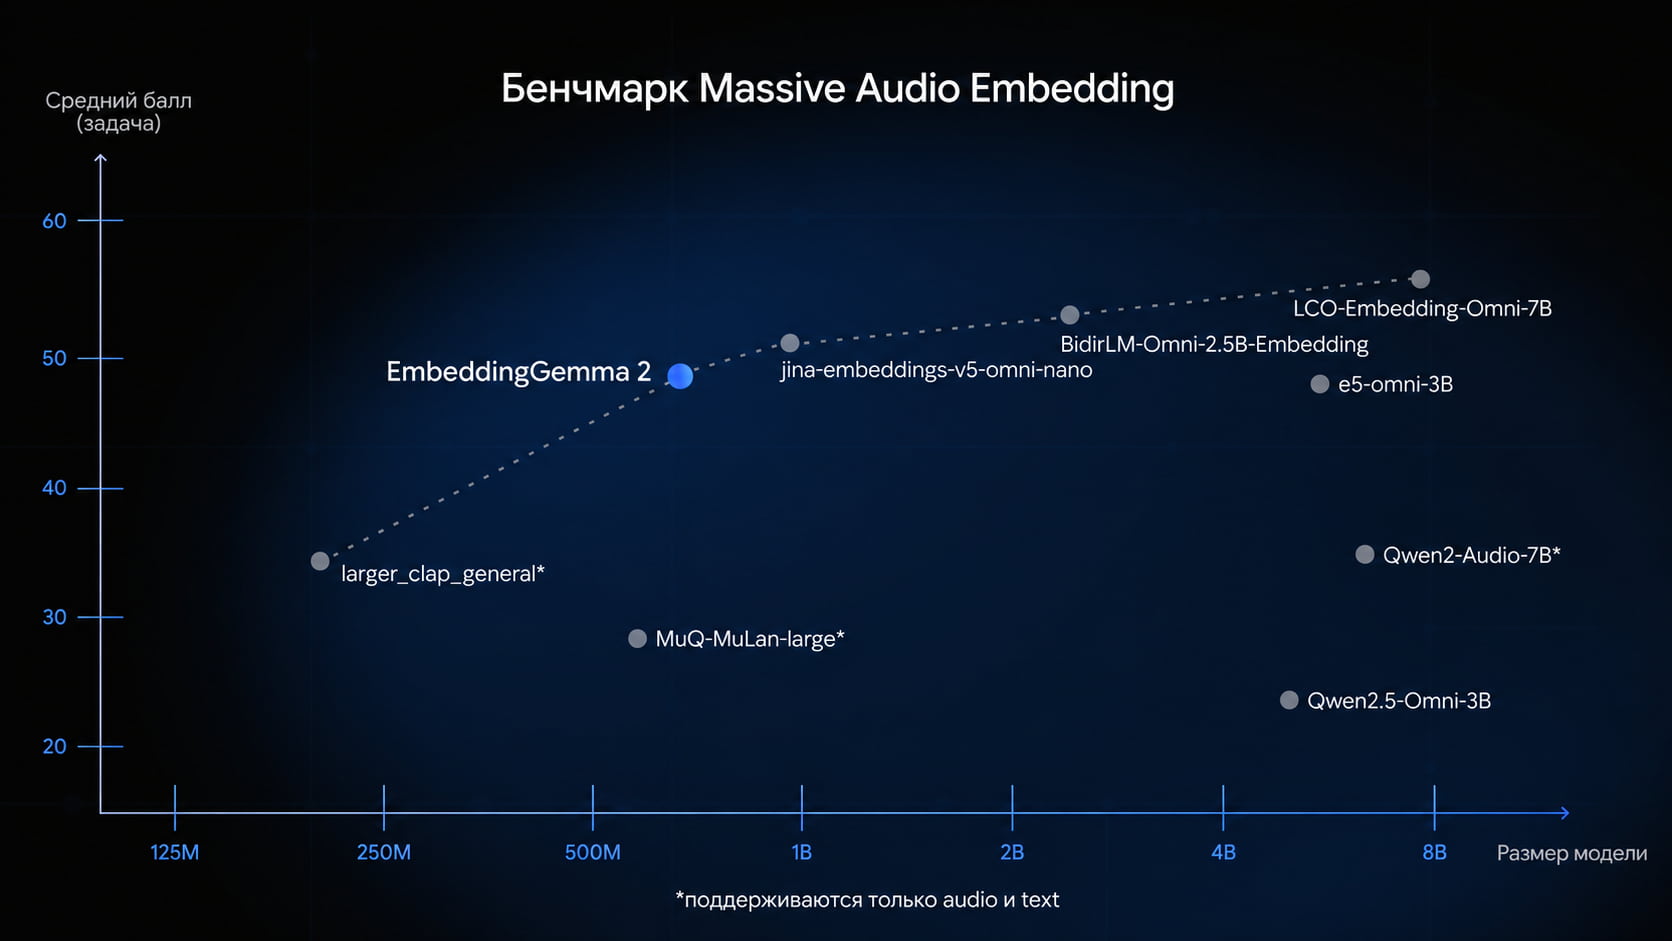
- поиск звуков (MSEB) — 69,54.
Сравнения с конкурентами по именам в материалах нет. Google пишет, что модель лидирует среди мультимодальных эмбеддеров до миллиарда параметров и обходит некоторые профильные модели вдвое крупнее, а в карточке модели цифры приведены только против первой EmbeddingGemma. Проверять заявление о лидерстве придётся независимым тестам.
Где EmbeddingGemma 2 проседает
Экономия места при обрезке вектора даётся не бесплатно. По данным самой Google, до 256 чисел потери почти незаметны, итоговый балл падает с 59,01 до 56,24. На 128 числах мультимодальное качество проседает до 45,65, то есть обещанная шестикратная экономия обходится примерно в четверть точности.
Поиск по видео остаётся самым слабым направлением EmbeddingGemma 2. Языков заявлено больше сотни, но Google оговаривается, что качество на них неодинаковое. Есть и техническая тонкость для тех, кто будет запускать модель сам. Она работает в форматах bfloat16 и float32, а в float16 выдаёт пустые значения.
Открытая альтернатива Gemini Embedding 2
У Google уже есть мультимодальная модель эмбеддингов Gemini Embedding 2, она вышла весной и работает только через платный облачный API. EmbeddingGemma 2 закрывает обратную сторону. Её можно скачать, дообучить и встроить в коммерческий продукт без отчислений и без отправки данных на чужие серверы. Похоже, Google делит рынок по привычной схеме: тяжёлые задачи уходят в облако, приватные и офлайновые остаются на устройстве, и в обоих случаях разработчик остаётся внутри экосистемы Gemini и Gemma.
Где скачать EmbeddingGemma 2
Веса EmbeddingGemma 2 уже лежат на Hugging Face и Kaggle, там же есть оптимизированные версии для мобильного движка LiteRT. Модель поддерживают Ollama, LM Studio, llama.cpp, vLLM, MLX и библиотека Sentence Transformers, а через transformers.js её можно запустить прямо в браузере. В облачном каталоге Model Garden модель появится позже, как и поддержка в ML Kit для Android-приложений.
Поиск по сайту без внешнего API
Для владельцев сайтов EmbeddingGemma 2 открывает дешёвый путь к смысловому поиску на своём сервере. Каталог интернет-магазина можно проиндексировать и по описаниям, и по фотографиям товаров, архив статей станет находиться по смыслу запроса даже без точного совпадения слов. Начинать разумно с вектора в 256 чисел и текстового модуля, а энкодеры изображений и звука подключать, когда в них появится реальная потребность.
Настоящая проверка для EmbeddingGemma 2 начнётся с приходом в ML Kit. Когда модель станет системным компонентом Android, станет видно, превратится ли поиск по голосу и картинкам в обычную функцию приложений или останется эффектной демонстрацией.