Сколько памяти нужно Mac mini для локальных нейросетей
Выберите нейросеть: она откроется в новой вкладке. Понадобится ваш доступ к выбранному сервису.
- ChatGPT запрос отправится сразу Открыть с запросом ChatGPT, откроется в новой вкладке
- Perplexity запрос отправится сразу Открыть с запросом Perplexity, откроется в новой вкладке
- Grok запрос подставится в поле Открыть с запросом Grok, откроется в новой вкладке
- DeepSeek скопируйте запрос и вставьте на сайте Открыть сайт DeepSeek, откроется в новой вкладке
- Алиса AI скопируйте запрос и вставьте на сайте Открыть сайт Алиса AI, откроется в новой вкладке
- GigaChat скопируйте запрос и вставьте на сайте Открыть сайт GigaChat, откроется в новой вкладке
Показать текст запроса
Сторонние сервисы работают по своим правилам: может понадобиться вход, действуют их лимиты и тарифы. Сайт передаёт им только текст запроса.
Короткий диалог с локальной нейросетью мало говорит о том, как она справится с рабочей задачей. Модель может бодро отвечать на пару строк и надолго задуматься, когда ей передают главы рукописи. Если компьютер покупают именно для локального ИИ, проверять конфигурацию стоит на самом длинном запросе, который будет повторяться изо дня в день.
У компьютеров на Apple Silicon и CPU, и GPU используют объединённую память. Из одного и того же объёма свою долю берут macOS, приложения и сама нейросеть. Системе нужны запасы под веса модели, промежуточные вычисления и контекст диалога. Поэтому размер скачанного файла годится для первого отбора, а точный запас виден только при запуске.
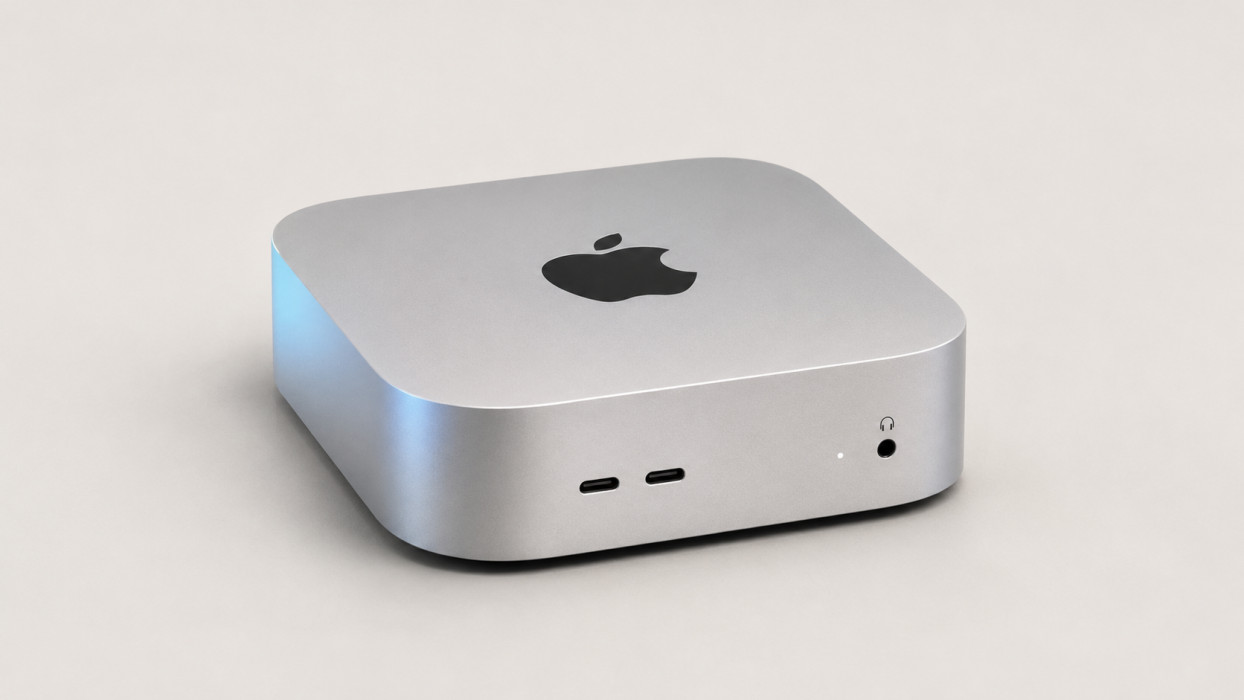
На примере компактного Mac mini с M5 Pro разница между конфигурациями заметна уже по спецификации Apple. Компания указывает 24 ГБ в базовом варианте и опции на 48 и 64 ГБ. В карточках на https://rifastore.ru/categories/mac-mini-m5-pro память и ёмкость накопителя указаны отдельно. При сравнении вариантов выпишите оба значения в разные колонки. Дополнительное место на SSD позволяет сохранить больше файлов с моделями, а размер задачи, которую удастся удержать в памяти, зависит от количества доступных гигабайт объединённой памяти.
Память для весов и контекста
Веса одной модели могут выпускаться с разной точностью. Например, четырёхбитная сборка обычно занимает меньше памяти, чем восьмибитная сборка той же модели. Сильнее сжатые веса иногда ухудшают ответ на запросах, где важны имена, числа и строгий формат. Возьмите пару страниц со знакомыми данными и попросите модель извлечь оттуда даты и обязательства. Так легче увидеть, пригодна ли компактная сборка для вашей работы.
Контекст тоже расходует память. Во время обработки текста движок хранит промежуточные данные об уже прочитанных токенах. Расход зависит от архитектуры модели и настроек запуска. Если короткий запрос работает, увеличьте объём входа до длины рабочего документа. Для поиска по архиву часто достаточно передавать несколько найденных фрагментов. При редактуре длинного текста может понадобиться широкий контекст, чтобы модель видела связи между разделами.
Как сравнить два запуска
В Ollama начните с одной локальной модели. Сделайте два запроса с одинаковым заданием и разным объёмом исходника. Для второго оставьте открытыми только те программы, которые обычно нужны рядом с моделью. Повторите длинный запрос несколько раз с разными фрагментами документа, чтобы понять, стабильно ли ведёт себя конфигурация.
- Запишите время до появления первого слова. Этот интервал помогает оценить, насколько удобно отправлять на обработку большой входной текст.
- Посмотрите, как быстро ответ движется после первой строки. Для диалога важна скорость продолжения, для пакетной обработки полезнее время до полного результата.
- Откройте вкладку «Память» в «Мониторинге системы». Следите за графиком нагрузки на память и изменением объёма подкачки прямо во время длинного запроса. Устойчивый рост подкачки вместе с задержками указывает, что системе тесно.
- Сверьте несколько ответов с исходным документом. Если модель перепутала роли участников или потеряла отрицание, дополнительная память сама по себе такую ошибку не исправит.
Как читать результат
Для коротких запросов к одной модели разумной отправной точкой служит младшая конфигурация. Если рабочий тест показывает подкачку, сначала попробуйте более компактную сборку или уменьшите контекст, если задача это позволяет. Если из-за этого ответы теряют нужные сведения, появляется измеримый повод брать больше памяти. Для нескольких одновременно загруженных моделей проверьте совместный запуск. По результату отдельного теста каждой модели сложно судить о поведении всей связки.
Заведите карточку замера, если выбираете компьютер заранее. Запишите точную сборку модели, объём контекста, открытые программы и две контрольные цифры по времени. По этим данным можно повторить тест на другой машине и понять, решит ли старшая конфигурация вашу задачу. Списки совместимых моделей помогают сузить поиск, а решение о памяти удобнее принимать по задержкам и качеству ответов на своих документах.
Поможет ли внешний SSD запускать более крупную модель?
На SSD удобно хранить скачанные модели, когда на внутреннем накопителе мало места. Во время работы параметры модели и промежуточные данные по-прежнему занимают объединённую память.
Как увидеть, где Ollama запустила модель?
Команда ollama ps показывает колонку PROCESSOR. По ней видно, загружена ли модель в GPU целиком или вычисления распределены между CPU и GPU.