NVIDIA разложила окупаемость ИИ-фабрик на три фактора
NVIDIA выпустила материал о том, как её платформа влияет на возврат инвестиций в ИИ-фабрики. Речь о вычислительных комплексах под обучение и работу нейросетей, которые операторы сдают в аренду или используют внутри себя. Компания строит аргумент вокруг трёх свойств своей платформы и подкрепляет его замерами сторонних аналитиков.
Доход держится на трёх вещах
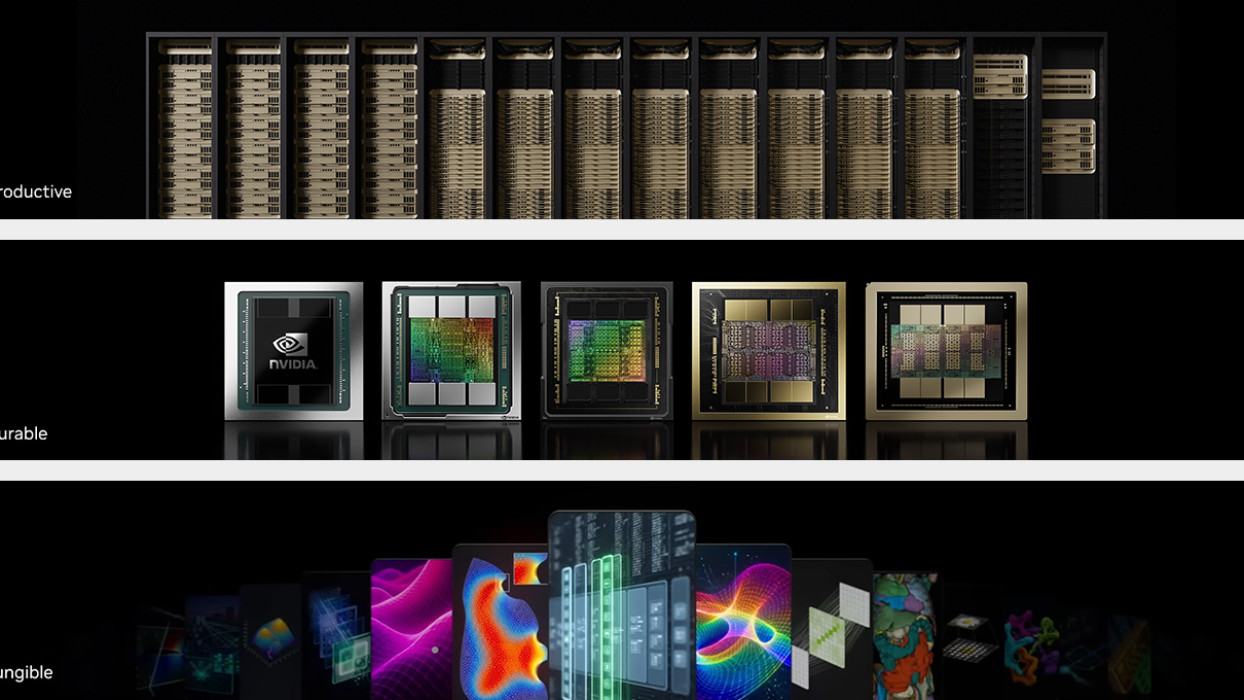
Отдачу фабрики определяют три фактора. Первый, выручка, это сколько она заработала бы за год, продав все токены, которые способна произвести. Второй, срок полезной службы, это как долго её оборудование продолжает приносить деньги. Третий, спрос, это сколько покупателей готовы платить за эти токены.
Сила в одном факторе не перекрывает слабость в другом. Высокая производительность мало помогает, если фабрика продаёт лишь часть выпуска. Большой спрос не спасёт, если через год оборудование перестанет работать на полную мощность. Факторы связаны между собой, и фабрика, которая тянет больше разных задач, находит и больше спроса.
Производительность упирается в электричество
Мощность остаётся главным ограничением ИИ-фабрики. Ключевая цифра здесь, сколько токенов в секунду даёт один мегаватт. Больше токенов в том же энергетическом конверте означает больше выручки, а низкая себестоимость токена даёт больше маржи.
По данным SemiAnalysis AgentX, системы NVIDIA Vera Rubin NVL72 выдают более чем в 30 раз большую пропускную способность на мегаватт, чем NVIDIA GB300 NVL72, и до 45 раз меньшую стоимость миллиона токенов на модели DeepSeek V4 Pro. Такой разрыв компания объясняет сквозной совместной оптимизацией всего стека, от моделей и рабочих нагрузок до софта, вычислений, сетей и памяти.
Отсюда вопрос, не сократится ли спрос на вычисления, если каждое поколение резко удешевляет токены. NVIDIA отвечает, что спрос растёт. Дешёвые токены делают выгодными новые сценарии, а они съедают больше токенов, чем экономит эффективность.
Прошлые поколения продолжают зарабатывать
Не всякой задаче нужна новейшая система. Подходящее железо зависит от сложности и формы нагрузки, поэтому предыдущее поколение продолжает приносить деньги после выхода следующего. GPU NVIDIA A100 вышел в 2020 году и спустя шесть лет всё ещё работает в коммерческой эксплуатации. CoreWeave недавно продлила контракты на блоки, впервые представленные в 2020 году, до 2029 года.
Крупные операторы год за годом продлевают срок амортизации серверов, то есть сдвигают оценку того, когда железо перестаёт зарабатывать. Анализ Sprout «The Productive Life of a Data Center GPU» за сентябрь 2026 года отслеживает, как этот график менялся у каждого крупного оператора. Учётный срок службы остаётся осторожной оценкой физического. Парк NVIDIA V100 у Microsoft отработал 8,4 года против шестилетнего балансового срока. Barkr оценивает полезную жизнь восьми-GPU системы на H100 в пять-шесть лет, а GB300 NVL72 в девять-десять лет, исходя из цен перепродажи. Silicon Data показывает, что шестилетний A100 стоит четверть первоначальной цены, тогда как при пятилетней амортизации он обнулился бы больше года назад. Ornn Data фиксирует, что рынок платит за аренду A100 по пятилетнему контракту 80 процентов от цены месячного.
Программная платформа CUDA работает через поколения, поэтому уже купленное железо не оказывается брошенным при выходе новой архитектуры. Постоянная оптимизация софта и ядер улучшает то, что умеет установленное оборудование.
Одна архитектура под разные задачи
Фабрика, заточенная под один вид работы, это ставка на то, что работа не изменится. NVIDIA строит расчёт на обратном. Её фабрики запускают модели любого типа, открытые и проприетарные, в областях языка, зрения, биологии, физики и робототехники. Они закрывают все этапы, от обработки данных до предобучения, дообучения и вывода, и работают в любом месте, от гиперскейлеров и ИИ-облаков до государственных программ, корпоративных дата-центров и периферии.
Часть нагрузки вообще не связана с ИИ. Та же инфраструктура считает обработку данных, научные расчёты, симуляции и графику. Всё это сводится к одной параллельной математике, под которую и сделаны GPU NVIDIA. На CUDA работают более 1000 готовых библиотек CUDA-X, от глубоких нейросетей и вычислительной литографии до квантового моделирования, векторного поиска и климатических моделей, а на платформе строят свыше 10 миллионов разработчиков. Именно это отличает GPU NVIDIA от специализированного чипа под одну задачу.
Универсальность не означает обезличенность. Tensor Cores и Transformer Engine добавляют ИИ-оптимизированное железо внутрь программируемой архитектуры, давая специализацию и гибкость в одном чипе. Одна архитектура под всё поддерживает высокую загрузку и вместе с ней доход.
Кто уже так работает
Примеры из рабочей эксплуатации показывают, как это выглядит на практике.
- Lilly. Строит и запускает модели белков, малых молекул и геномики на локальном кластере из 1016 GPU, плюс чат-боты и агентные сценарии для своих команд.
- Pinterest. Дообучает и разворачивает мультимодальную модель зрения и языка в гиперскейл-облаке на 14 000 GPU, охватывающих NVIDIA Blackwell, Hopper и более ранние архитектуры.
- Revolut. Обрабатывает данные миллиардов транзакций через NVIDIA cuDF, затем обучает и разворачивает базовую модель в ИИ-облаке.
- Runway . Обучает world-модель на NVIDIA Hopper и обслуживает её на платформе NVIDIA Blackwell в облаке.
- Texas A&M University. Запускает молекулярное моделирование и ИИ-поиск лекарств на своём суперкомпьютере с загрузкой 95-98 процентов по 26 проектам и семи организациям.
За пределами ИИ картина та же. Dassault Systèmes питает симуляцию виртуальных двойников для сертификации самолётов в Wichita State и проектирования машин в Lucid Motors. Unilever собирает изображения продуктов из цифровых двойников вместо фотосессий и режет расходы на производство вдвое.
Что это значит для арендатора
Для того, кто берёт вычисления в аренду, аргумент NVIDIA звучит так. Чем дольше живёт железо и чем больше задач оно тянет, тем меньше риск, что цена за токен вырастет при смене поколения. Практическая проверка проста. Смотрите не на пиковую производительность новой системы, а на то, сколько лет оператор готов держать её в строю и какие нагрузки, кроме ИИ, она берёт.
Обратная сторона в том, что все цифры экономики приводит сама NVIDIA или связанные с ней аналитики. Независимых замеров стоимости токена на Vera Rubin NVL72 в открытом доступе пока нет. Дженсен Хуанг расскажет больше на своём кейноуте GTC Berlin 21 октября в 11 часов по центральноевропейскому времени.